Agent 答一句话要 45 秒?用 OTel GenAI 语义约定做全链路追踪
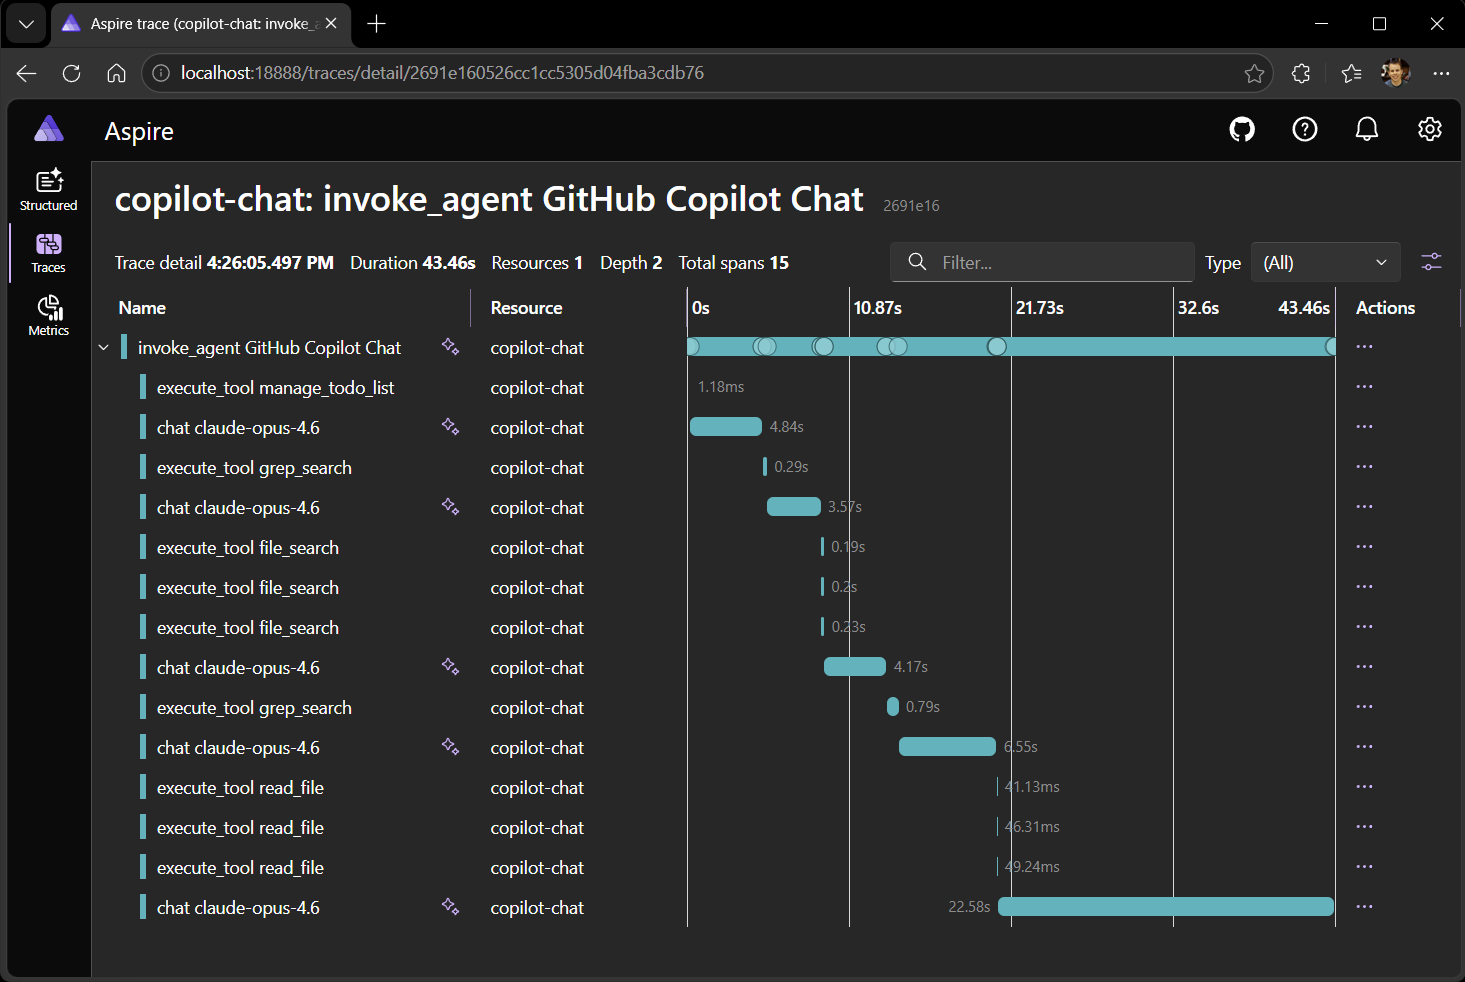
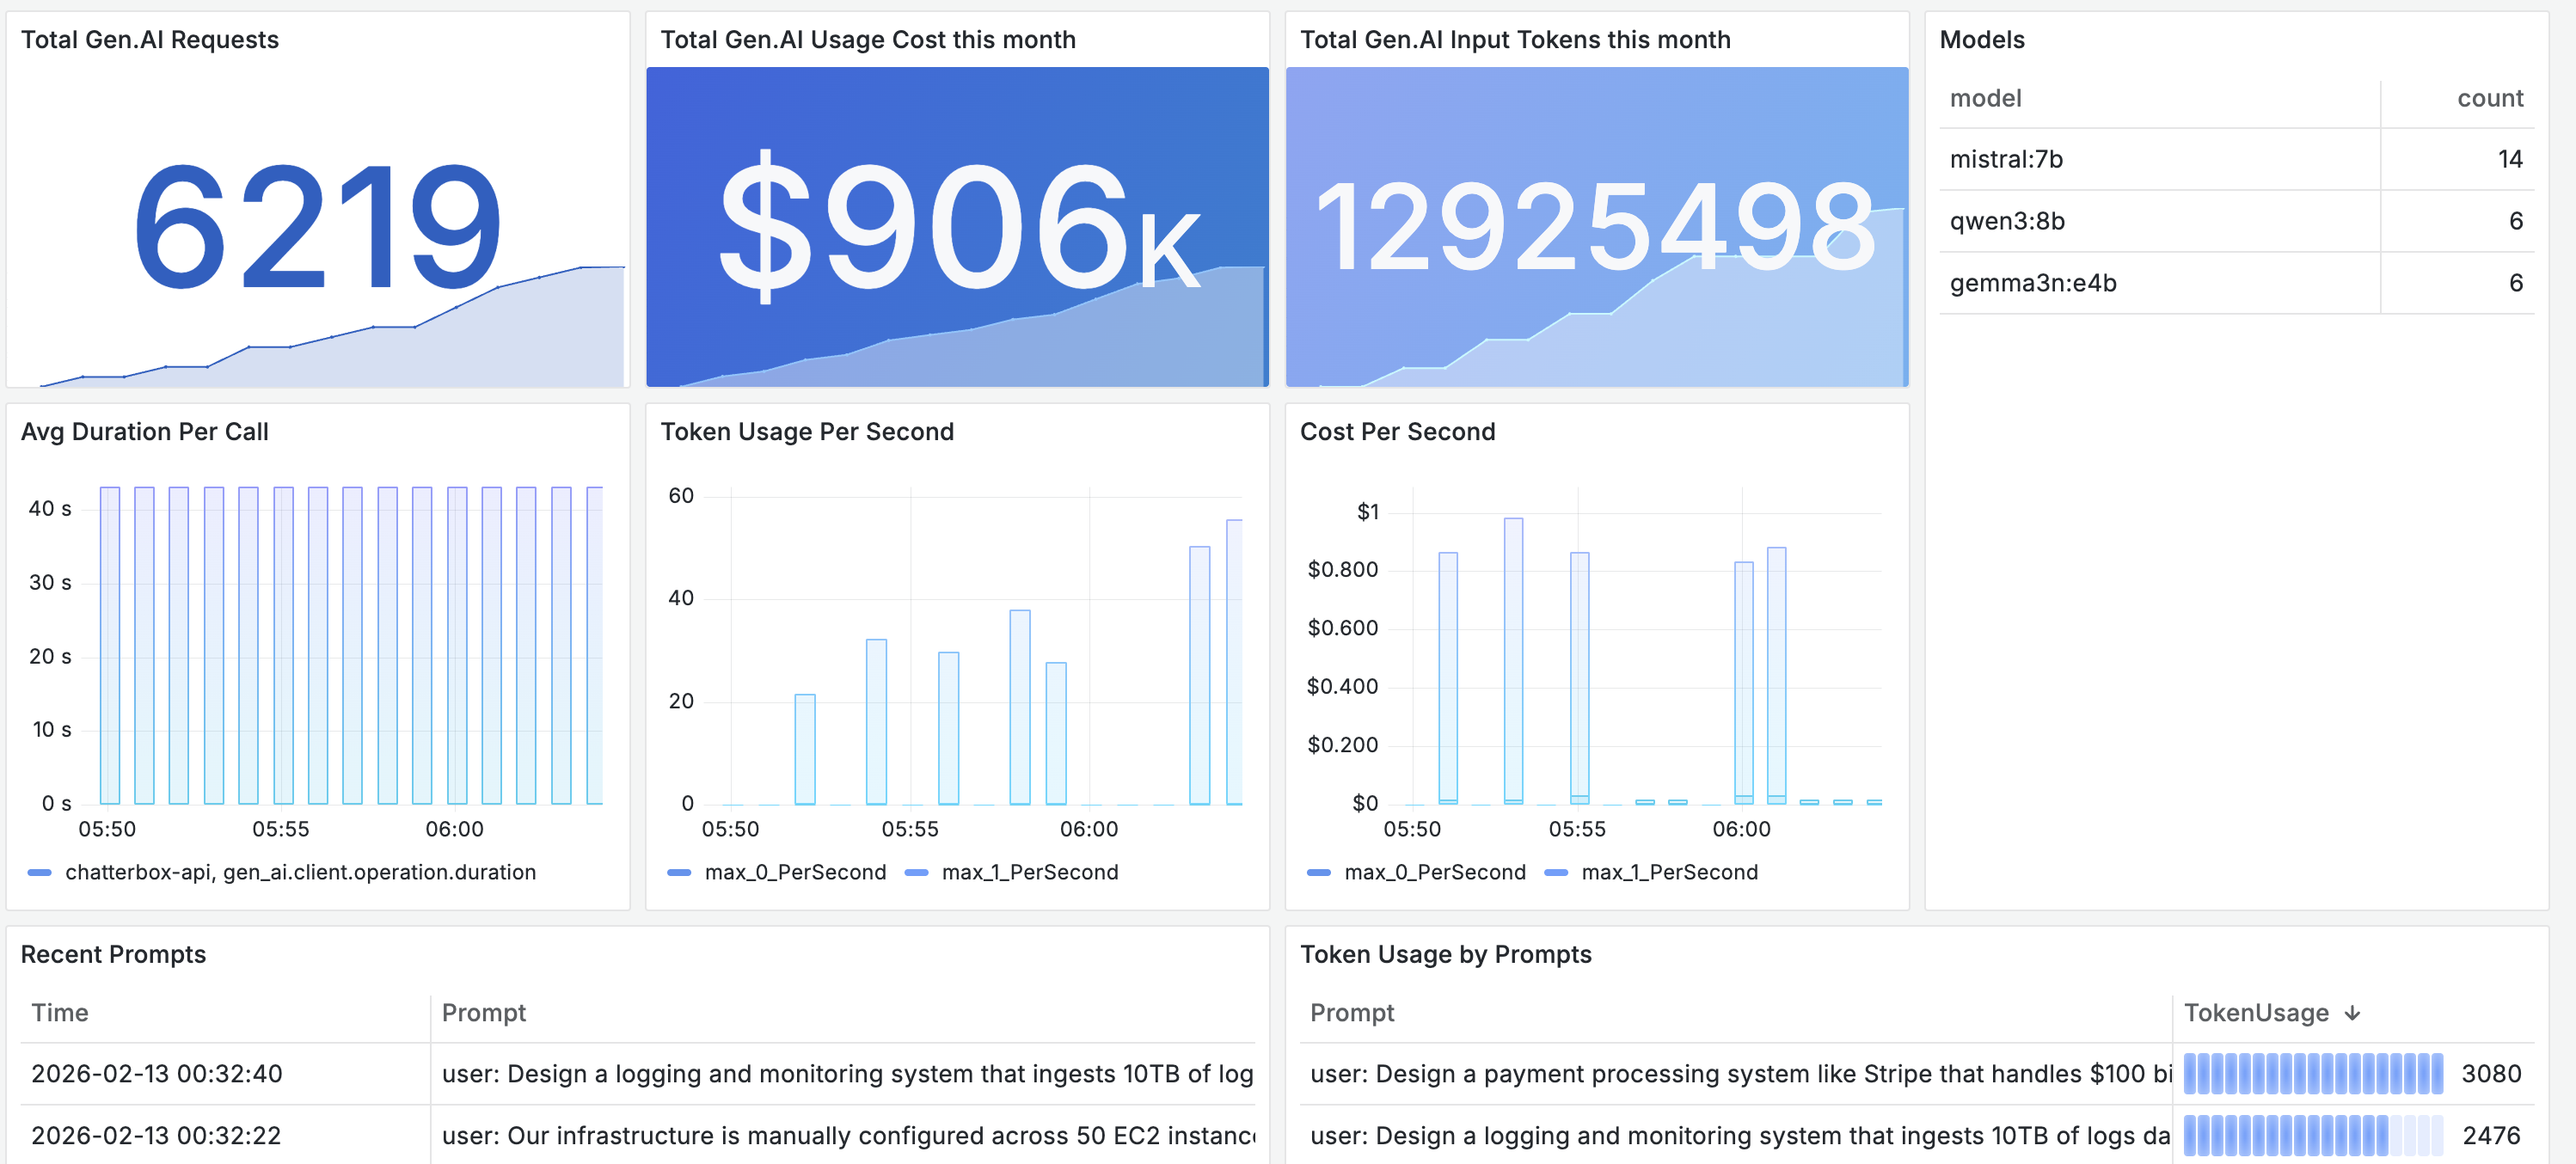
一次用户提问、九次模型调用、四次工具调用、两次检索——没有统一语义的可观测性,你只能对着最终那段 prompt 猜。
开篇:从一个真实业务场景说起
线上客服 Agent 的平均响应时间从 3.2 秒涨到了 45 秒,用户投诉,老板催。你打开日志,看到的是这样一行:最终 prompt 3200 token,耗时 45.2 秒。然后呢?然后就没有然后了。
真实的原因可能有五种:模型被路由到了一个慢节点;某个工具的 HTTP 超时后 SDK 静默重试了三轮;Agent 陷入了「检索→不满意→再检索」的循环;上下文膨胀到 128k 之后 prefill 变慢;或者某次 fallback 切到了备用供应商,而备用供应商的 p95 是你的主供应商的六倍。这五种原因在传统 APM 里长得几乎一样——都是一条 POST /v1/chat/completions 的慢请求。
这就是本文要解决的单点问题:如何用一套厂商中立、跨进程、可查询的标准语义,把 LLM / Agent 的一次请求还原成一棵可解释的 span 树。答案是 OpenTelemetry(下称 OTel)的 GenAI 语义约定(GenAI Semantic Conventions)。它不是又一个 SDK,而是一份「属性名契约」:模型名必须落在 gen_ai.request.model,而不是 model / modelName / llm_model。
读完这篇,你应该能做到三件事:给自己的 Agent 埋出符合规范的 trace;用 Collector 在数据出网前完成脱敏与降量;用 token 词表算出一份不会算错的成本账。
技术背景与核心概念扫盲
传统语义约定为什么覆盖不了 LLM
OTel 已有的语义约定(HTTP、数据库、RPC)是为「短、确定性、按请求计费」的调用设计的。LLM 调用在三个维度上越界了:
- 计费单位是 token,不是请求。一个 HTTP span 关心状态码和耗时;一次 LLM span 必须带上
gen_ai.usage.input_tokens与gen_ai.usage.output_tokens,否则你无法做成本归因。一次「慢请求」可能消耗了平时 10 倍的预算,而 QPS 曲线毫无波动。 - 请求参数会改变语义,而不只是改变性能。
temperature、top_p、max_tokens直接决定输出内容,传统 HTTP 约定里没有对应概念(query 参数通常不会改变响应语义)。 - 最值得调试的产物恰好是最敏感的数据。排查慢 SQL 很少需要读行数据,排查一个坏答案却几乎必须读原始 prompt 和 completion。
在这份约定出现之前,各家插桩各造字段:OpenInference 用 llm.model_name,OpenLLMetry 用 gen_ai.prompt.N.content,自研 wrapper 用 llm_model。三个库的数据拼不进同一张看板。
规范的演进时间线(截至 2026-11)
GenAI SIG 于 2024 年 4 月在 Semantic Conventions SIG 下成立,最初只做 LLM 客户端调用的追踪,后续扩展到 Agent 编排、MCP 工具调用、内容捕获与质量评估。几个关键版本:
| 版本 | GenAI 相关变化 |
|---|---|
| v1.37 | 重写多轮对话记录方式,逐消息事件改为 gen_ai.system_instructions / gen_ai.input.messages / gen_ai.output.messages 聚合属性;gen_ai.system 被 gen_ai.provider.name 取代 |
| v1.38 | 新增评估事件、工具定义与调用详情、invoke_agent 的 span kind 指南、embedding 维度、多模态 JSON schema |
| v1.39 | 引入 MCP 语义约定 |
| v1.40 | 新增 retrieval span、缓存 token 属性、Anthropic 输入 token 计算说明 |
| v1.41 | execute_tool 的 span 名必须带工具名;新增 reasoning token、invoke_workflow、流式指标;invoke_agent 拆分为 CLIENT / INTERNAL |
两个必须知道的现实:其一,GenAI 规范正文已经迁出主仓库,落到独立的 semantic-conventions-genai 仓库,其 model/manifest.yaml 声明的 schema URL 形如 https://opentelemetry.io/schemas/gen-ai-dev/1.42.0-dev,并依赖核心语义约定的 1.44.0(该状态核对于 2026-10-06)。其二,所有 GenAI 信号目前仍是 Development 状态,属性名仍可能在版本间变动;而 error.type、server.address 这些借用自通用约定的属性是 Stable。用一句话记住:管道是稳的,词表还在动。所以你要固定插桩版本,并把看板建在一层可改名的记录规则之上。
规范定义的六类内容
- 模型调用 span:
chat/text_completion/generate_content/embeddings/retrieval/ memory 系列 - Agent span:
create_agent、invoke_agent、invoke_workflow、plan - 工具执行 span:
execute_tool - 指标:客户端/服务端的时长与 token 直方图
- 事件:可选的完整请求详情(
gen_ai.client.inference.operation.details)、评估结果 - 供应商特化规则(Anthropic / OpenAI / AWS Bedrock / Azure AI Inference)与 MCP
底层原理深度拆解
四层参考架构
真正的契约在「插桩库 → SDK」与「Collector → 后端」两处。插桩库负责把业务事实翻译成 gen_ai.*;SDK 负责批量与导出;Collector 负责策略(脱敏、归一、过滤、采样);后端只负责存和查。任何一层都不该承担其他层的职责,后面所有踩坑几乎都源于职责错位。
flowchart LR
    A["业务应用 / Agent 框架<br/>LangGraph · OpenAI SDK"] --> B["GenAI 插桩库<br/>生成 gen_ai.* 属性"]
    B --> C["OTel SDK<br/>BatchSpanProcessor"]
    C -->|OTLP/HTTP| D["OTel Collector<br/>normalize · redact · filter"]
    D --> E["Trace 存储<br/>Tempo / ClickHouse"]
    D --> F["Metrics 存储<br/>独立管线,不受采样影响"]
    E --> G["看板与告警<br/>p95 · token · 成本"]
    F --> G
span 模型:命名、kind 与三级属性
推理 span 的命名规则是 {gen_ai.operation.name} {gen_ai.request.model},于是 chat gpt-4o-mini、generate_content gemini-2.5-flash 这样的名字让 trace 瀑布图不用展开就能读懂。span kind 通常为 CLIENT(模型在远端、或调用跨越了被插桩的协议);同进程内的本地模型可用 INTERNAL。
属性分三级,这个分级对「看板能建多深」影响极大:
- Required:
gen_ai.operation.name、gen_ai.provider.name。后者是「遥测风味」的判别符——你请求的是gpt-4o,但经由 Azure OpenAI 时provider.name应为azure.ai.openai,否则供应商特化属性无从挂载。 - Conditionally required:
gen_ai.request.model、失败时的error.type、框架存在会话时的gen_ai.conversation.id、要求 JSON 输出时的gen_ai.output.type、以及设置了server.address时的server.port。 - Recommended:采样参数(
temperature/top_p/max_tokens/stop_sequences)、响应信息(gen_ai.response.id/gen_ai.response.model/gen_ai.response.finish_reasons)与 usage。
两个细节值得单独记住。第一,gen_ai.response.finish_reasons 是数组(["stop"]、["tool_calls"]),因为一次响应理论上可以有多个 choice,很多自研埋点在这里写成字符串,导致后端按数组查询时全部落空。第二,gen_ai.conversation.id 不允许编造:规范明确把「新生成一个 UUID」「用 trace ID 顶替」「对请求内容做哈希」列为反模式——伪造的会话 ID 在后端看起来像真实会话,会系统性污染按会话聚合的分析。
重试规则:一个 span 覆盖一次「逻辑操作」
规范说得很清楚:GenAI span 表达的是调用方视角的逻辑操作,从发起到响应完整接收(或被错误/取消终止)。如果一次瞬时失败触发了自动重试,这个 span 应该覆盖包含重试的整个逻辑操作。
这条规则的工程后果是双向的。按规范做,你看到的是一个耗时含退避的 span——正是用户真实感受到的延迟;代价是你看不到重试了几次。很多 SDK(OpenAI、Anthropic)默认在单次调用内部静默重试,于是「看起来只调了一次,花了 12 秒」成为最常见的困惑。要看到每次尝试,就得在应用层关掉 SDK 内部重试(max_retries=0)自己重试——两种做法都合法,但必须选一种并让看板口径一致,不能一半服务按逻辑操作、一半按物理尝试。
usage 词表:缓存与推理 token 的计费陷阱
token 属性早已不止 input/output。当前规范还定义了 gen_ai.usage.cache_read.input_tokens、gen_ai.usage.cache_write.input_tokens、gen_ai.usage.reasoning.output_tokens,以及按模态拆分的变体(文本/图像/音频)。这跟随的是真实计费方式:命中缓存的前缀更便宜,推理 token 按输出计费但不出现在 completion 文本里。
最容易算错的一条:gen_ai.usage.input_tokens 包含被缓存的部分,缓存属性是它的子集。如果你直接用 input_tokens × 输入单价,命中缓存的 prompt 会被高估。而 reasoning.output_tokens 是 output_tokens 的子集,再加一次就是重复计费。正确公式:
cost = (input_tokens - cache_read_tokens) × price_in
     + cache_read_tokens × price_cached
     + output_tokens × price_out          # reasoning 已含在 output 里,勿重复相加
Agent span 树:把「黑盒推理」摊平成结构
Agent 层是 GenAI 约定与传统 OTel 分歧最大的地方——分布式追踪里有 HTTP、RPC、DB span,但从来没有「调用 Agent」这种操作。
| 操作 | gen_ai.operation.name |
span 名 | kind |
|---|---|---|---|
| 调用远端 Agent | invoke_agent |
invoke_agent {gen_ai.agent.name} |
CLIENT |
| 调用进程内 Agent | invoke_agent |
invoke_agent {gen_ai.agent.name} |
INTERNAL |
| 执行工作流 | invoke_workflow |
使用 gen_ai.workflow.name |
未强断言 |
| 任务规划 | plan |
plan {gen_ai.agent.name} |
未强断言 |
| 执行工具 | execute_tool |
execute_tool {gen_ai.tool.name} |
INTERNAL |
| 检索 | retrieval |
retrieval {gen_ai.data_source.id} |
CLIENT |
CLIENT 与 INTERNAL 的区分是最常被写错的一处。一个进程内的函数型 Agent 必须用 INTERNAL;一个通过 HTTP 调用的托管 Agent 必须用 CLIENT。写错不会报错,但会让服务拓扑图画出边缘模糊的假依赖。
graph TD
    W["invoke_workflow support-triage · 根 span"] --> A1["invoke_agent triage · INTERNAL"]
    A1 --> P["plan triage"]
    A1 --> C1["chat gpt-4o-mini · CLIENT"]
    A1 --> T1["execute_tool kb_search · INTERNAL"]
    T1 --> R["retrieval kb-v3 · CLIENT"]
    A1 --> C2["chat gpt-4o-mini · CLIENT"]
    A1 --> A2["invoke_agent refund-agent · CLIENT"]
    A2 --> C3["chat claude-sonnet-4 · CLIENT"]
    A2 --> T2["execute_tool create_refund · INTERNAL"]
这棵树能回答日志回答不了的问题:退款 Agent 是在知识库查询结束之后才被调用的吗?第二次模型调用的 8 秒里,prefill 占多少?工具失败后模型是否又盲目重试了两轮?
MCP 层:修复断成两半的 trace
MCP(Model Context Protocol)在 2025 年迅速铺开,也带来了一个具体的可观测性问题:Agent 侧产生 Trace A,MCP Server 侧产生 Trace B,中间没有上下文传播,两条 trace 互不相识。v1.39 引入的 MCP 语义约定补上了这块:客户端 span 携带 mcp.method.name(如 tools/call)、mcp.session.id、mcp.protocol.version、jsonrpc.request.id,stdio 传输时 network.transport=pipe。当两侧都传播 W3C Trace Context(traceparent),Server span 会正确嵌套在 Client span 之下,形成 tools/call get-weather (CLIENT) → tools/call get-weather (SERVER) 的连续链。
规范还规定了去重行为:若 MCP 插桩检测到外层 GenAI 插桩已经在追踪该次工具执行,它应当增强已有 span(补上 MCP 属性)而不是再建一个重复 span。
内容捕获:为什么 prompt 不能当 span 属性
这是所有团队至少踩过一次的坑:prompt 与 completion 不是标准 span 属性。理由是属性天生被索引、有大小上限,且内容通常含姓名、邮箱、账号、合同条款。
规范把内容建模为独立的、显式开启的机制。历史上有两次重要变化:早期是逐消息 span event(v1.37 因为事件洪水而改为聚合属性 + gen_ai.client.inference.operation.details 事件);opentelemetry-instrumentation-openai-v2 在 2025 年 10 月(PR #3628)之后,内容改为以 log event 形式产出,而不是 span event。于是今天正确的查询姿势是:从 span 拿到 trace_id,再带着它去日志流里捞内容,而不是指望在属性面板看到对话。
当前 GenAI 插桩包的开关是 OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT,取值为 no_content / span_only / event_only / span_and_event。true / false 不是合法值——库会打一条警告然后什么都不抓。而且该模式在 instrument() 执行时被读取一次,运行时改环境变量无效。
指标:两个直方图 + 流式指标
标准化的两个 instrument 是 gen_ai.client.token.usage(每次请求的 token 数)与 gen_ai.client.operation.duration(秒)。它们携带与 span 相同的核心属性(provider.name、request.model、operation.name),所以可以按供应商、模型、操作任意切分,不需要 join span 数据。v1.41 还补齐了流式指标(首 chunk 时间、每输出 chunk 时间),这正是流式体验类 SLO 需要的口径。
属性注入的时序:为什么「事后补属性」会失败
自动插桩在 span 创建时写 Required 属性、在结束时写 usage 与 finish_reasons。span 一旦 end() 就不可变,这是所有「想加个成本属性」的需求撞墙的地方。三条可行路径:SpanProcessor.on_start(能改,但必须在插桩库写属性之前/之后抢到时机)、SpanExporter 包装并重建 span(能改任何东西,代价是要复制),或 Collector 的 transform 处理器(最省事,但只在你控制的网络上)。
sequenceDiagram
    participant U as 业务请求
    participant P as SpanProcessor.on_start
    participant I as 插桩库
    participant E as 自定义 SpanExporter
    participant C as OTel Collector
    U->>P: 进入请求上下文(tenant / conversation_id / agent)
    P->>P: 校验 instrumentation scope 是否属于 GenAI 包
    P->>I: 在 span 启动时写入业务属性
    I->>I: 调用结束,写入 usage 与 finish_reasons
    I->>E: end() 之后 span 不可变
    E->>E: 重建 span:派生 cost、兜底脱敏
    E->>C: OTLP 导出
    C->>C: redaction → filter → 归一化
手把手实战落地
版本矩阵(本节代码核对口径:2026-10-06 前后官方发布线)。
| 组件 | 版本 |
|---|---|
opentelemetry-instrumentation-genai-openai |
1.2b0(承接 opentelemetry-instrumentation-openai-v2) |
opentelemetry-instrumentation-genai-anthropic |
1.2b0 |
opentelemetry-instrumentation-google-genai |
1.2b0 |
opentelemetry-sdk / -api |
1.45.0 |
| FastAPI / SQLAlchemy / httpx 插桩 | 0.66b0 |
| OTel Collector Contrib | 0.161.0 |
第 1 步:最小可运行埋点
# minimal_trace.py —— 20 行拿到第一条符合 GenAI 语义约定的 trace
import os
from opentelemetry import trace
from opentelemetry.sdk.resources import Resource
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.sdk.trace.export import BatchSpanProcessor
from opentelemetry.exporter.otlp.proto.http.trace_exporter import OTLPSpanExporter
from opentelemetry.instrumentation.genai.openai import OpenAIInstrumentor

# 1) 默认不抓取 prompt/completion,生产环境务必保持 no_content
os.environ.setdefault("OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT", "no_content")

resource = Resource.create({
    "service.name": "support-agent",              # 必填:后端按它分组服务
    "deployment.environment.name": "prod",        # 区分环境,看板过滤靠它
    "service.version": "2026.11.1",
})

provider = TracerProvider(resource=resource)
provider.add_span_processor(
    BatchSpanProcessor(                       # 批量导出,避免同步阻塞请求路径
        OTLPSpanExporter(endpoint="http://collector:4318/v1/traces")
    )
)
trace.set_tracer_provider(provider)

# 2) 必须在创建任何 client 之前完成插桩
OpenAIInstrumentor().instrument()

from openai import OpenAI
client = OpenAI(max_retries=0)               # 关键:关掉 SDK 内部重试,让每次尝试各成一个 span
resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "帮我查一下订单 A1024 的物流"}],
    temperature=0.2,
)
# 自动产出 span:chat gpt-4o-mini(CLIENT)
#   gen_ai.operation.name / provider.name / request.model /
#   response.model / usage.input_tokens / usage.output_tokens / finish_reasons
第 2 步:本地起一个能看 span 树的后端
# Aspire Dashboard:单容器、内置 trace/metrics/log 视图,适合本地调试
docker run --rm -p 18888:18888 -p 4317:18889 -p 4318:18890 -d \
  --name aspire-dashboard \
  -e ASPIRE_DASHBOARD_UNSECURED_ALLOW_ANONYMOUS=true \
  mcr.microsoft.com/dotnet/aspire-dashboard:latest
# 浏览器打开 http://localhost:18888 ,Traces 页即可看到 chat gpt-4o-mini
# 官方建议把 OTLP endpoint 指向 http://localhost:4318
第 3 步:手写 Agent 骨架,补齐插桩库「不知道」的部分
插桩库只能看到模型调用,它不知道这是哪个 Agent、服务于哪个租户、当前是哪轮会话。这些必须由你在业务代码里用标准属性补齐。
# agent_trace.py —— 手工构建 invoke_workflow → invoke_agent → execute_tool 树
from opentelemetry import trace
from opentelemetry.trace import SpanKind, Status, StatusCode

tracer = trace.get_tracer("support-agent.workflow")


def run_workflow(task: str, conversation_id: str) -> str:
    # 根 span:用户可见的一次请求。不要用 gen_ai.* 命名空间装业务字段
    with tracer.start_as_current_span(
        "invoke_workflow support-triage",
        kind=SpanKind.INTERNAL,
        attributes={
            "gen_ai.operation.name": "invoke_workflow",
            "gen_ai.workflow.name": "support-triage",
            "gen_ai.conversation.id": conversation_id,   # 真实会话 ID,禁止用 UUID 伪造
        },
    ) as wf:
        try:
            answer = triage_agent(task)
            wf.set_attribute("support.escalated", False)
            return answer
        except Exception as e:
            wf.record_exception(e)                        # 保留堆栈
            wf.set_status(Status(StatusCode.ERROR, str(e)))
            wf.set_attribute("error.type", type(e).__qualname__)  # 失败时 error.type 是条件必填
            raise


def triage_agent(task: str) -> str:
    with tracer.start_as_current_span(
        "invoke_agent triage",
        kind=SpanKind.INTERNAL,                          # 进程内函数型 Agent → INTERNAL
        attributes={
            "gen_ai.operation.name": "invoke_agent",
            "gen_ai.agent.name": "triage",
            "gen_ai.agent.version": "2026.11.1",
        },
    ) as agent_span:
        docs = kb_search(task)                           # 内部自带 retrieval 子 span
        answer = call_model(task, docs)                  # 自动插桩产出 chat span
        agent_span.set_attribute("agent.tool_calls_total", 1)
        return answer


def kb_search(query: str) -> str:
    # 工具 span 命名必须带工具名(v1.41 起强制)
    with tracer.start_as_current_span(
        "execute_tool kb_search",
        kind=SpanKind.INTERNAL,
        attributes={
            "gen_ai.operation.name": "execute_tool",
            "gen_ai.tool.name": "kb_search",
            "gen_ai.tool.call.id": "call_01",
            # 工具入参/结果仅在隐私策略允许时记录,且应截断长度
        },
    ) as tool_span:
        # 检索子 span:数据源用 gen_ai.data_source.id 标识
        with tracer.start_as_current_span(
            "retrieval kb-v3",
            kind=SpanKind.CLIENT,
            attributes={
                "gen_ai.operation.name": "retrieval",
                "gen_ai.data_source.id": "kb-v3",
            },
        ) as r:
            hits = ["退款政策 7 天无理由", "物流时效 48 小时"]
            r.set_attribute("retrieval.documents_count", len(hits))
        tool_span.set_attribute("gen_ai.tool.call.result", f"{len(hits)} docs")  # 生产建议只记长度
        return "\n".join(hits)
第 4 步:用 SpanProcessor 注入业务上下文(不改业务代码)
# context_processor.py —— 把 tenant / agent / 成本中心挂到自动生成的 chat span 上
from contextvars import ContextVar
from opentelemetry.sdk.trace import Span, SpanProcessor
from opentelemetry.context import Context

# 请求级上下文:在入口处 set,协程间自动传递
_biz_ctx: ContextVar[dict] = ContextVar("biz_ctx", default={})


def set_biz_context(tenant_id: str, conversation_id: str, agent_name: str | None = None) -> None:
    _biz_ctx.set({"tenant_id": tenant_id, "conversation_id": conversation_id, "agent": agent_name})


def _is_genai_span(span: Span) -> bool:
    """只处理 GenAI 插桩包产生的 span,避免污染 FastAPI/SQLAlchemy span。"""
    scope = span.instrumentation_scope
    return bool(scope) and (scope.name or "").startswith("opentelemetry.instrumentation.genai")


class BizContextProcessor(SpanProcessor):
    def on_start(self, span: Span, parent_context: Context | None = None) -> None:
        ctx = _biz_ctx.get()
        if not ctx or not _is_genai_span(span):
            return
        # on_start 阶段写入的属性优先级高于插桩库创建 span 时的默认值
        attrs = {}
        if ctx.get("agent"):
            attrs["gen_ai.agent.name"] = ctx["agent"]
        if ctx.get("conversation_id"):
            attrs["gen_ai.conversation.id"] = ctx["conversation_id"]
        # 业务字段自带前缀:gen_ai.* 是规范保留命名空间,不得占用
        attrs["app.tenant.id"] = ctx.get("tenant_id")
        span.set_attributes(attrs)

    def on_end(self, span: Span) -> None:      # 必须实现:这里做不了修改,只能清理
        pass
第 5 步:在 Exporter 里派生成本属性 + 兜底脱敏
# cost_exporter.py —— finished span 不可变,因此包装 exporter 并重建 span
import re
from opentelemetry.sdk.trace import ReadableSpan
from opentelemetry.sdk.trace.export import SpanExporter, SpanExportResult
from opentelemetry.sdk.resources import Resource

# 单位:美元 / 百万 token;只放必要模型,缺失即按 0 计(本地模型适用)
PRICING = {
    "gpt-4o-mini": {"in": 0.15, "cached_in": 0.075, "out": 0.60},
    "claude-sonnet-4": {"in": 3.00, "cached_in": 0.30, "out": 15.00},
}
_EMAIL = re.compile(r"[\w.+-]+@[\w-]+\.[\w.]+")
_PHONE = re.compile(r"1[3-9]\d{9}")


def calc_cost(model: str, inp: int, cached: int, out: int) -> float:
    p = PRICING.get(model)
    if not p:
        return 0.0
    cached = min(cached, inp)                 # cache_read 是 input 的子集,防御异常数据
    return ((inp - cached) * p["in"] + cached * p["cached_in"] + out * p["out"]) / 1_000_000


class CostScrubExporter(SpanExporter):
    def __init__(self, wrapped: SpanExporter):
        self._wrapped = wrapped

    def export(self, spans: list[ReadableSpan]) -> SpanExportResult:
        rebuilt = []
        for s in spans:
            attrs = dict(s.attributes or {})
            if attrs.get("gen_ai.operation.name") in {"chat", "text_completion", "generate_content"}:
                model = attrs.get("gen_ai.response.model") or attrs.get("gen_ai.request.model")
                cost = calc_cost(
                    str(model),
                    int(attrs.get("gen_ai.usage.input_tokens") or 0),
                    int(attrs.get("gen_ai.usage.cache_read.input_tokens") or 0),
                    int(attrs.get("gen_ai.usage.output_tokens") or 0),   # reasoning 已含于此,勿重复加
                )
                attrs["app.gen_ai.cost_usd"] = cost          # 业务前缀,避免占用规范命名空间
                # 兜底脱敏:即使误开了内容捕获,也不让 PII 出网
                for k in ("gen_ai.input.messages", "gen_ai.output.messages"):
                    if isinstance(attrs.get(k), str):
                        v = _EMAIL.sub("[email]", attrs[k])
                        attrs[k] = _PHONE.sub("[phone]", v)[:800]   # 截断,控制体积
            rebuilt.append(self._rebuild(s, attrs))
        return self._wrapped.export(rebuilt)

    @staticmethod
    def _rebuild(s: ReadableSpan, attrs: dict):
        # 用 SDK 的 _Span 重建成本过高,实践里更常用:SDK 层改为在 on_end 前派生,
        # 或用 Collector 的 transform 处理器派生。此处仅为演示重建思路。
        return s.__class__(  # 简化示意:真实项目建议改用 Collector 派生
            name=s.name, context=s.get_span_context(), parent=s.parent,
            resource=s.resource or Resource.create({}), attributes=attrs,
            events=s.events, links=s.links, kind=s.kind,
            start_time=s.start_time, end_time=s.end_time, status=s.status,
        )

    def force_flush(self, timeout_millis: int = 30000) -> bool:
        return self._wrapped.force_flush(timeout_millis)

    def shutdown(self) -> None:
        self._wrapped.shutdown()
工程建议:成本的派生优先放在 Collector(
transform处理器 + 价格表),比在应用里重建 span 稳得多,也更符合「应用只负责事实、Collector 负责策略」的分层。
第 6 步:自己补两个指标——成本计数器与首字延迟
# metrics.py —— 规范只定义了两个直方图,成本与 TTFT 需要你补
from opentelemetry import metrics

meter = metrics.get_meter("support-agent.metrics")
cost_counter = meter.create_counter(
    "app.gen_ai.cost", unit="USD", description="按模型/Agent 归因的推理成本"
)
ttft_hist = meter.create_histogram(
    "app.gen_ai.ttft", unit="s", description="流式首 chunk 延迟"
)


def record_stream(stream, model: str, agent: str):
    """包装流式响应:统计 TTFT 与增量 token,结束时记一次成本。"""
    import time
    t0, ttft, out_chars = time.perf_counter(), None, 0
    for chunk in stream:
        if ttft is None:
            ttft = time.perf_counter() - t0
            ttft_hist.record(ttft, {"gen_ai.request.model": model, "gen_ai.agent.name": agent})
        delta = chunk.choices[0].delta.content or ""
        out_chars += len(delta)
        yield chunk
    # 注意:流式下 usage 只在流完成后可得,中断的流没有 usage,cost 会缺口
    out_tokens = int(out_chars / 3)  # 粗略估算;精确值应以最终 usage 为准
    cost_counter.add(
        calc_cost(model, 0, 0, out_tokens),
        {"gen_ai.request.model": model, "gen_ai.agent.name": agent},
    )
第 7 步:Collector 生产配置(归一化 + 脱敏 + 降量)
# otel-collector.yaml —— 职责:归一化老 schema、出网前脱敏、过滤噪音、保护自身
extensions:
  health_check: {}

receivers:
  otlp:
    protocols:
      grpc: { endpoint: 0.0.0.0:4317 }
      http: { endpoint: 0.0.0.0:4318 }

processors:
  memory_limiter:                 # 必须最先执行:先保护自己,再干活
    check_interval: 1s
    limit_percentage: 80
    spike_limit_percentage: 20

  gen_ai_normalizer:              # contrib 中的 alpha 组件,把 OpenInference/OpenLLMetry 归一
    sources:
      - name: openinference
        remove_originals: true    # 归一后删除旧名,看板只见一套字段
      - name: openllmetry
        remove_originals: true

  transform:
    trace_statements:
      - context: resource
        statements:
          - set(resource.attributes["deployment.environment.name"], "${env:DEPLOY_ENV}")
          - set(resource.attributes["app.team"], "${env:TEAM_OWNER}")   # 成本归因维度
      - context: span
        statements:
          # 内容属性超过 2KB 直接截断,防止后端起爆
          - truncate_all(attributes, 2048)
          # 明确禁止出网的属性:删除优于遮蔽
          - delete_key(attributes, "gen_ai.tool.call.arguments")

  redaction:                      # 值级遮蔽:保留会话可读性,只遮蔽命中模式
    allow_all_keys: true
    blocked_values:
      - "sk-[A-Za-z0-9]{20,}"          # API Key
      - "[0-9]{17}[0-9Xx]"             # 身份证号
      - "4[0-9]{12}(?:[0-9]{3})?"      # 卡号
    # 最严格模式(会丢失会话视图):
    # blocked_key_patterns: ["gen_ai\\.input\\.messages", "gen_ai\\.output\\.messages"]

  filter:
    traces:
      span:
        - 'attributes["http.route"] == "/health"'    # 健康检查无分析价值
        - 'IsMatch(name, "^health.*")'

exporters:
  otlp_http:
    endpoint: https://api.honeycomb.io
    headers: { x-honeycomb-team: "${env:HONEYCOMB_API_KEY}" }
    sending_queue:                # 由 exporter 承担批处理与重试(当前推荐做法)
      enabled: true
      sizer: items
      queue_size: 100000

service:
  extensions: [health_check]
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, gen_ai_normalizer, transform, redaction, filter]
      exporters: [otlp_http]
    metrics:
      receivers: [otlp]
      processors: [memory_limiter]
      exporters: [otlp_http]      # 指标管线独立:采样 trace 不能影响计数器
第 8 步:重试与降级——让失败可见
# retry_fallback.py —— 每次尝试各成 span,降级切供应商记录在业务属性上
from tenacity import Retrying, RetryCallState, retry_if_exception_type, stop_after_attempt, wait_exponential

retry_counter = meter.create_counter("app.gen_ai.retry", unit="1", description="重试次数")
fallback_counter = meter.create_counter("app.gen_ai.fallback", unit="1", description="供应商降级次数")


def _on_retry(rs: RetryCallState) -> None:
    exc = rs.outcome.exception() if rs.outcome else None
    retry_counter.add(1, {
        "gen_ai.provider.name": "openai",
        "error.type": type(exc).__qualname__ if exc else "unknown",   # 如 RateLimitError
        "app.retry.attempt": rs.attempt_number,
    })


def call_with_fallback(messages: list[dict], primary: str, backup: str) -> str:
    for provider, model in ((primary, "gpt-4o-mini"), (backup, "claude-sonnet-4")):
        try:
            r = Retrying(
                stop=stop_after_attempt(3),
                wait=wait_exponential(multiplier=0.5, max=8),
                retry=retry_if_exception_type(Exception),
                before_sleep=_on_retry,
            ).call(lambda: get_client(provider, max_retries=0).chat(model, messages))
            return r
        except Exception as e:
            # 降级记录在当前 span 上,但不把 span 置为失败(业务最终成功)
            trace.get_current_span().set_attribute("app.provider.fallback_from", provider)
            trace.get_current_span().set_attribute("error.type", type(e).__qualname__)
            fallback_counter.add(1, {"gen_ai.provider.name": provider, "error.type": type(e).__qualname__})
    raise RuntimeError("all providers failed")
关键细节与踩坑指南
| 现象 | 错误做法 | 正确做法 |
|---|---|---|
| 开了内容捕获但什么都没抓到 | OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT=true |
用 span_only / event_only / span_and_event / no_content,且在 instrument() 前设置(只读一次) |
| 看不到 prompt 内容 | 在 span 属性面板找 | 从 trace_id 跳日志流。2025-10 后 openai-v2 系产出的内容走 log event,不是 span event |
| 重复 span、字段打架 | 同时装了 -openai、-openai-v2、-genai-openai |
只装一个;老 opentelemetry-instrumentation-openai(Traceloop 系)与官方线并存会双写 |
| 「只调了一次,花了 12 秒」 | 用 SDK 默认重试 | 要么按规范让一个 span 覆盖含重试的逻辑操作,要么 max_retries=0 让每次尝试成 span,全站统一口径 |
| 流式请求的 token 是 0 | 在首个 chunk 时读 usage | usage 只在流结束可得;中断/取消的流必须接受 usage 缺口,在指标侧标注 app.stream.aborted=true |
看板按 gen_ai.system 查不到 |
沿用老属性 | v1.37 起改为 gen_ai.provider.name;同时看到两者说明库版本混杂 |
| Ollama / DeepSeek 被记成 openai | 信任插桩默认值 | OpenAI 兼容端点经 OpenAI SDK 调用时 provider.name 有误,在 on_start 里按 scope 纠正 |
finish_reasons 过滤失效 |
写成字符串 | 必须是数组:["stop"]、["tool_calls"]、["length"] |
| 子 span 断链、trace 变两条 | 在线程池 / Celery / MCP stdio 里直接起 span | 显式传递 context(start_as_current_span(context=ctx));跨进程靠 W3C traceparent 传播 |
| span 数量爆炸、账单失控 | 每个 chunk、每个 token 建 span | 用 filter 过滤零 token span 与冗长子步骤;内容走 event/log 并截断到 500–1000 字符 |
| 多轮对话被采样切断 | 对 GenAI span 做 head sampling | 会话完整性优先:GenAI 流量不采样,靠 filter 与属性裁剪降量;非 GenAI 管线再上尾采样 |
| 成本虚高 2–3 倍 | input_tokens × 单价,再把 reasoning token 加一次 |
先减 cache_read(它是 input 的子集);reasoning 已含在 output 内,不得重复相加 |
| 升级插桩后看板全空 | 属性被重命名 | 固定版本;用 Collector 的 schema/transform 做版本转译;看板建在记录规则之上 |
| 容器 OOM 崩掉 Collector | 只配 exporter | memory_limiter 必须第一个执行;sending_queue 控制积压 |
一个容易被忽略的细节:gen_ai.conversation.id 不要为了「看起来完整」而伪造。规范明确把 UUID 凭空生成、复用 trace ID、哈希请求内容列为反模式——它会在后端凭空造出「会话」,让留存率、轮次分布这类分析全部失真。
生产环境最佳实践
分层职责:应用只写事实(哪个模型、多少 token、哪个工具),Collector 统一写策略(脱敏、过滤、归一、派生成本),后端只存查。
必带 resource 属性:service.name、deployment.environment.name、service.version、app.team(成本中心)。缺了 app.team,成本归因无从谈起。
SLO 与告警口径(全部从两个标准直方图与你的补充计数派生):
p95 gen_ai.client.operation.duration,按(provider.name, request.model)分组- 流式场景加
app.gen_ai.ttft的 p95 - 错误率:
error.type维度(RateLimitError/TimeoutError/ContentPolicyError) - 每千次请求成本:
app.gen_ai.cost÷ 请求数;同时监控gen_ai.usage.input_tokens的 p99 突增 - 重试与降级:
app.gen_ai.retry、app.gen_ai.fallback的环比
安全三条底线:生产默认 no_content;开启时只对特定服务开,并在 Collector 出口做值级遮蔽;工具入参与检索片段默认不出网(delete_key 优于遮蔽)。
成本降量:先 filter 噪音(健康检查、零 token span、无查询价值的子步骤),再裁属性长度,最后才是采样——且 GenAI 会话流量原则上不采样。
高可用:Collector 前置 memory_limiter + sending_queue,sidecar 或 DaemonSet 部署;health_check 暴露存活探针;trace 与 metrics 分成两条管线,避免采样影响计数。
横向对比与选型建议
| 方案 | 与 OTel 的关系 | 许可证 | 适合场景 | 注意 |
|---|---|---|---|---|
| OTel GenAI 官方插桩 + 任意 OTLP 后端 | 规范原生 | Apache-2.0 | 想彻底避免锁定、已有可观测体系 | 包仍是 beta 线,属性随版本演进 |
| Langfuse | 作为 OTLP 后端,映射 GenAI 约定 | MIT | 需要标注、评估、人工打分闭环 | 目前不支持 gRPC OTLP;2026-01 被 ClickHouse 收购,自托管与 MIT 保留 |
| Arize Phoenix | OTel 原生,自家 OpenInference 约定 | Elastic License 2.0 | RAG / 检索质量评估见长 | ELv2 非 OSI 开源,禁止转售托管服务 |
| LangSmith / 商业平台 | 多为专有 trace 格式 | 商业 | 追求开箱即用 | 迁移时往往要重埋点 |
| 网关侧采集(如 LiteLLM、Bifrost 类) | 在代理层产出 span/metrics | 各异 | 多模型统一入口、跨团队共享 | 只能看到网关内的事实,Agent 内部步骤仍需要应用埋点(公开压测显示异步采集额外开销约 11 微秒/请求 @5000 rps) |
| 自建 ClickHouse + Grafana | 纯存储与查询 | — | 数据主权、超大规模 | 要自己解决归一化与 UI |
决策路径(按顺序问自己):
- 已有 OTel 体系?→ 直接上官方 GenAI 插桩,别引入第二套 SDK。
- 需要人工标注与 LLM-as-judge 闭环?→ 插桩仍用 OTel,评估层选 Langfuse / Phoenix 之一。
- 强数据主权 / 金融医疗?→ OTel + 自建 Collector + 自建存储,内容默认不出网。
- 只有多模型路由需求、没有 Agent 内部步骤?→ 网关侧采集够用,别过度埋点。
- 计划把可观测能力作为 SaaS 再对外提供?→ 避开 ELv2 的 Phoenix。
性能实测与效果验证
先看公开的开销数据(口径:端到端单次请求的额外延迟,不含存储):
| 采集方式 | 额外开销 | 说明 |
|---|---|---|
SDK 内 BatchSpanProcessor(异步批量) |
通常 < 1 ms / 次 LLM 调用 | LLM 调用本身 100 ms–30 s,埋点占比 <1% |
| 网关异步采集 | 约 11 µs / 请求 @ 5000 rps | 厂商公开压测,异步采集不阻塞请求路径 |
同步导出(SimpleSpanProcessor) |
毫秒至数十毫秒 | 会把网络抖动直接注入用户延迟,生产禁用 |
你可以自己复现量级:
# bench.py —— 对比有无插桩的本地调用延迟(时间成本远低于 LLM 本身)
import statistics, time
from opentelemetry import trace
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.sdk.trace.export import BatchSpanProcessor, SimpleSpanProcessor
from opentelemetry.sdk.trace.export.in_memory_span_exporter import InMemorySpanExporter

def bench(processor_factory, n: int = 2000) -> float:
    p = TracerProvider()
    p.add_span_processor(processor_factory())
    trace.set_tracer_provider(p)
    tracer = trace.get_tracer("bench")
    samples = []
    for _ in range(n):
        t0 = time.perf_counter()
        with tracer.start_as_current_span("chat gpt-4o-mini") as s:
            s.set_attributes({"gen_ai.operation.name": "chat",
                              "gen_ai.provider.name": "openai",
                              "gen_ai.request.model": "gpt-4o-mini",
                              "gen_ai.usage.input_tokens": 900,
                              "gen_ai.usage.output_tokens": 120})
        samples.append((time.perf_counter() - t0) * 1000)
    return statistics.median(samples)

print("noop   :", bench(lambda: BatchSpanProcessor(InMemorySpanExporter())))
print("sync   :", bench(lambda: SimpleSpanProcessor(InMemorySpanExporter())))
再看存储成本(这才是账单主因)。按平均每次 LLM 调用 1 个 chat span、日均 20 万次调用测算:
xychart-beta
    title "不同内容策略下的月度 trace 存储量(估算:20 万调用/日,30 天)"
    x-axis ["仅元数据 3KB/span", "全量内容 35KB/span", "全量内容+保留10%"]
    y-axis "GB / 月" 0 --> 240
    bar [18, 210, 21]
- 仅元数据:200,000 × 3 KB × 30 ≈ 18 GB/月
- 开启
span_only全量内容:200,000 × 35 KB × 30 ≈ 210 GB/月(约 11.7 倍) - 全量内容但只保留 10% 采样:≈ 21 GB/月——但注意,这 10% 会切断多轮会话的完整性
结论很清晰:先裁属性与过滤噪音,再谈采样;内容捕获是成本的数量级开关,不是百分比开关。
效果验证:埋点前后应能回答下面这四个问题,否则说明树还没建对——
- 45 秒里,模型调用占多少、工具调用占多少、重试退避占多少?
- 第二次模型调用的 prefill 是否因为上下文膨胀而变慢(
usage.input_tokens与 duration 的散点)? - 失败集中在哪里(
error.type的分布,以及失败 span 的父节点)? - 成本前 10% 的请求有什么共性(
app.team/agent.name/input_tokens分位)?
行业侧的背景数据可以参考:2026 年的多项调研显示约 85% 的组织在规划 LLM 可观测性,而 OTel 在生产环境的采用率同比从 6% 升至 11%——标准化还在早期,这意味着现在建立规范化的埋点,迁移成本最低。
总结与未来展望
一句话回顾:GenAI 语义约定给了你一套共享词表,让你能把一次 Agent 请求还原成「工作流 → Agent → 模型 / 工具 / 检索」的可解释树,而工程量真正藏在属性注入时序、内容隐私边界与 token 计费口径这三处。
三个必须记住的判断:span 覆盖逻辑操作而非物理尝试(重试口径要统一);内容永远走 opt-in 事件/日志,绝不进属性;成本必须扣掉 cache_read 且不得重复计 reasoning。
趋势上,规范正处于 Development 阶段向稳定推进的窗口期,Agent、MCP 与评估层是仍在快速演进的部分;同时 GenAI SIG 已把「质量评估结果」标准化为事件(gen_ai.evaluation.result),这意味着 trace 与 eval 的合流——未来你会在同一条 trace 上同时看到「慢在哪」与「好不好」。下一步值得盯的是:稳定版规范发布节奏、streaming 指标的落地情况,以及语义约定迁移工具(schema processor)的成熟度。
延伸阅读
- OpenTelemetry GenAI 语义约定官方规范(含 span/指标/事件定义与稳定性标记)
- Inside the LLM Call:官方 GenAI 可观测性端到端演练(含 Aspire Dashboard 实操)
- OpenTelemetry Collector 的 LLM 可观测性配置手册(归一化、脱敏、降量的完整 YAML)
标签:OpenTelemetry、GenAI 语义约定、LLM 可观测性、AI Agent 追踪、OTel Collector、分布式追踪、Token 成本归因、MCP、AI 工程化