Agent 越跑越贵?OTel GenAI 语义约定全链路追踪与成本归因实战
一次 LLM 调用花多少钱、慢在哪一步、是不是在死循环——这些问题传统 APM 一个都答不上来。给 Agent 装黑匣子,本质是给「模型调用」这层抽象补一套标准词汇表。
开篇:从一个真实业务场景说起
去年给一家电商客服团队做诊断,现象很典型:一个售后 Agent 上线三个月,GMV 没涨多少,API 账单从每月 1.2 万涨到 4.8 万。SRE 打开监控看板,全是绿的——P99 延迟 3.2 秒、错误率 0.4%、CPU 健康。但用户投诉在涨:「转人工之前的机器人像失忆」「有时候一个问题要等 45 秒」。
于是我们开始查。发现三件事,一件比一件扎心:
第一,账单和监控对不上。监控里没有任何一个指标知道「Token」这件事。它只知道 HTTP 200,不知道这次 200 背后烧了 68k 输入 token。
第二,长尾延迟完全不可归因。那 45 秒的请求,到底是模型慢、向量检索慢、还是某个工具接口超时,trace 里没有答案——因为 RAG 检索、工具调用这些步骤根本没有埋点,整条链路只有一次 LLM SDK 调用是可见的。
第三,也是最贵的:约 3.7% 的会话吃掉了 41% 的 Token。原因不是 prompt 太长,而是工具调用失败后 Agent 会在原地重试,每一轮都把完整历史重新塞进上下文。这个循环在日志里只表现为「同一个 trace id 下 17 次 chat 调用」,而传统监控压根不认为这是异常——它每次都成功了。
后来我们做了一件事:把 LLM 应用按 OpenTelemetry 的 GenAI 语义约定(Semantic Conventions for Generative AI) 重新埋点,一个模型调用一个 span,一次 Agent 运行一个父 span,工具执行、检索各占一层,Token 作为一等公民写进属性与直方图。两周后,那 3.7% 的会话被一条 SQL 拉出来,加了最大轮次限制和上下文裁剪,Token 支出降了 46%,P99 从 45 秒回落到 4 秒以内。
这篇文章只讲这一件事:怎么用一套厂商中立的语义约定,把 LLM 应用的调用、成本、延迟、质量变成可查询的结构化数据。 无论你后端是 Jaeger、Grafana Tempo、Datadog、Langfuse 还是自建 ClickHouse,属性名都是同一套 gen_ai.*。
技术背景与核心概念扫盲
LLM 可观测性为什么不能复用 APM
传统链路追踪的语义约定解决的是「服务间调用」问题:http.request.method、db.system.name、rpc.grpc.status_code。这些名字对一次 chat.completions.create 毫无意义,原因有三:
- 计费口径是 token,不是请求数。 一个 HTTP span 记录状态码和耗时就够了;LLM span 必须记录输入/输出 token,因为账单按它结算。
- 请求参数影响的是输出语义,不只是性能。
temperature、top_p、max_tokens决定模型返回什么,而不只是返回多快。HTTP 的 query 参数没有这种语义权重。 - 内容本身就是排查对象,同时也是最敏感的数据。 查一个慢 SQL 不需要读行数据;查一个「胡说八道」的回答,你需要读 prompt 和 completion。
前两点要求新增字段,第三点要求一套「默认不采集、按需采集、可脱敏」的机制。这就是 GenAI 语义约定存在的理由。
这套约定从哪来、现在到哪一步了
2024 年 4 月,OpenTelemetry 在 Semantic Conventions SIG 下成立了 GenAI 特别兴趣组(GenAI SIG)。从最初的「给模型调用定几个属性」,扩展到现在覆盖六个层面的标准词汇表。关键里程碑(凭记忆和官方文档核对过):
| 版本 | GenAI 相关变更 |
|---|---|
| v1.37 | 重构对话历史记录方式(per-message events → gen_ai.input.messages / gen_ai.output.messages / gen_ai.system_instructions);gen_ai.system 改为 gen_ai.provider.name |
| v1.38 | 评估事件 gen_ai.evaluation.result;工具定义与调用详情;invoke_agent 的 span kind 指南;embedding 维度属性 |
| v1.39 | MCP 语义约定(解决 Agent 端与 MCP Server 端 trace 断裂) |
| v1.40 | Retrieval span;缓存 token 属性;Anthropic 输入 token 计算指南 |
| v1.41 | execute_tool span 名必须带工具名;reasoning token;invoke_workflow;流式指标;invoke_agent 拆分 CLIENT / INTERNAL |
| v1.42(2026-06-12) | GenAI 与 MCP 约定从核心仓库迁出,独立成 semantic-conventions-genai 仓库,旧的 opentelemetry.io/docs/specs/semconv/gen-ai/ 变成重定向存根 |
两个必须知道的现实:
- 全部
gen_ai.*属性目前都是 Development 稳定性。 一个 GenAI span 上唯一的 Stable 属性是继承来的error.type、server.address、server.port。这意味着属性名可以在小版本间被改名,没有弃用窗口。 - 新仓库目前没有打 tag 的 release。 它从
main发布,对应 schema 版本gen-ai/1.42.0,而 README 里 schema URL 还写着 TODO。所以"固定规范版本"这件事你只能在 instrumentation 层做——锁库版本、记录它声明的 schema 版本,并把原始属性字符串收敛到自己的映射层里。
听起来很危险?其实概念层已经稳定了。正确姿势是:基于规范构建,但把所有 gen_ai.* 字面量包在自己的常量模块里,并接受"某次升级要改看板"。
六层词汇表全貌
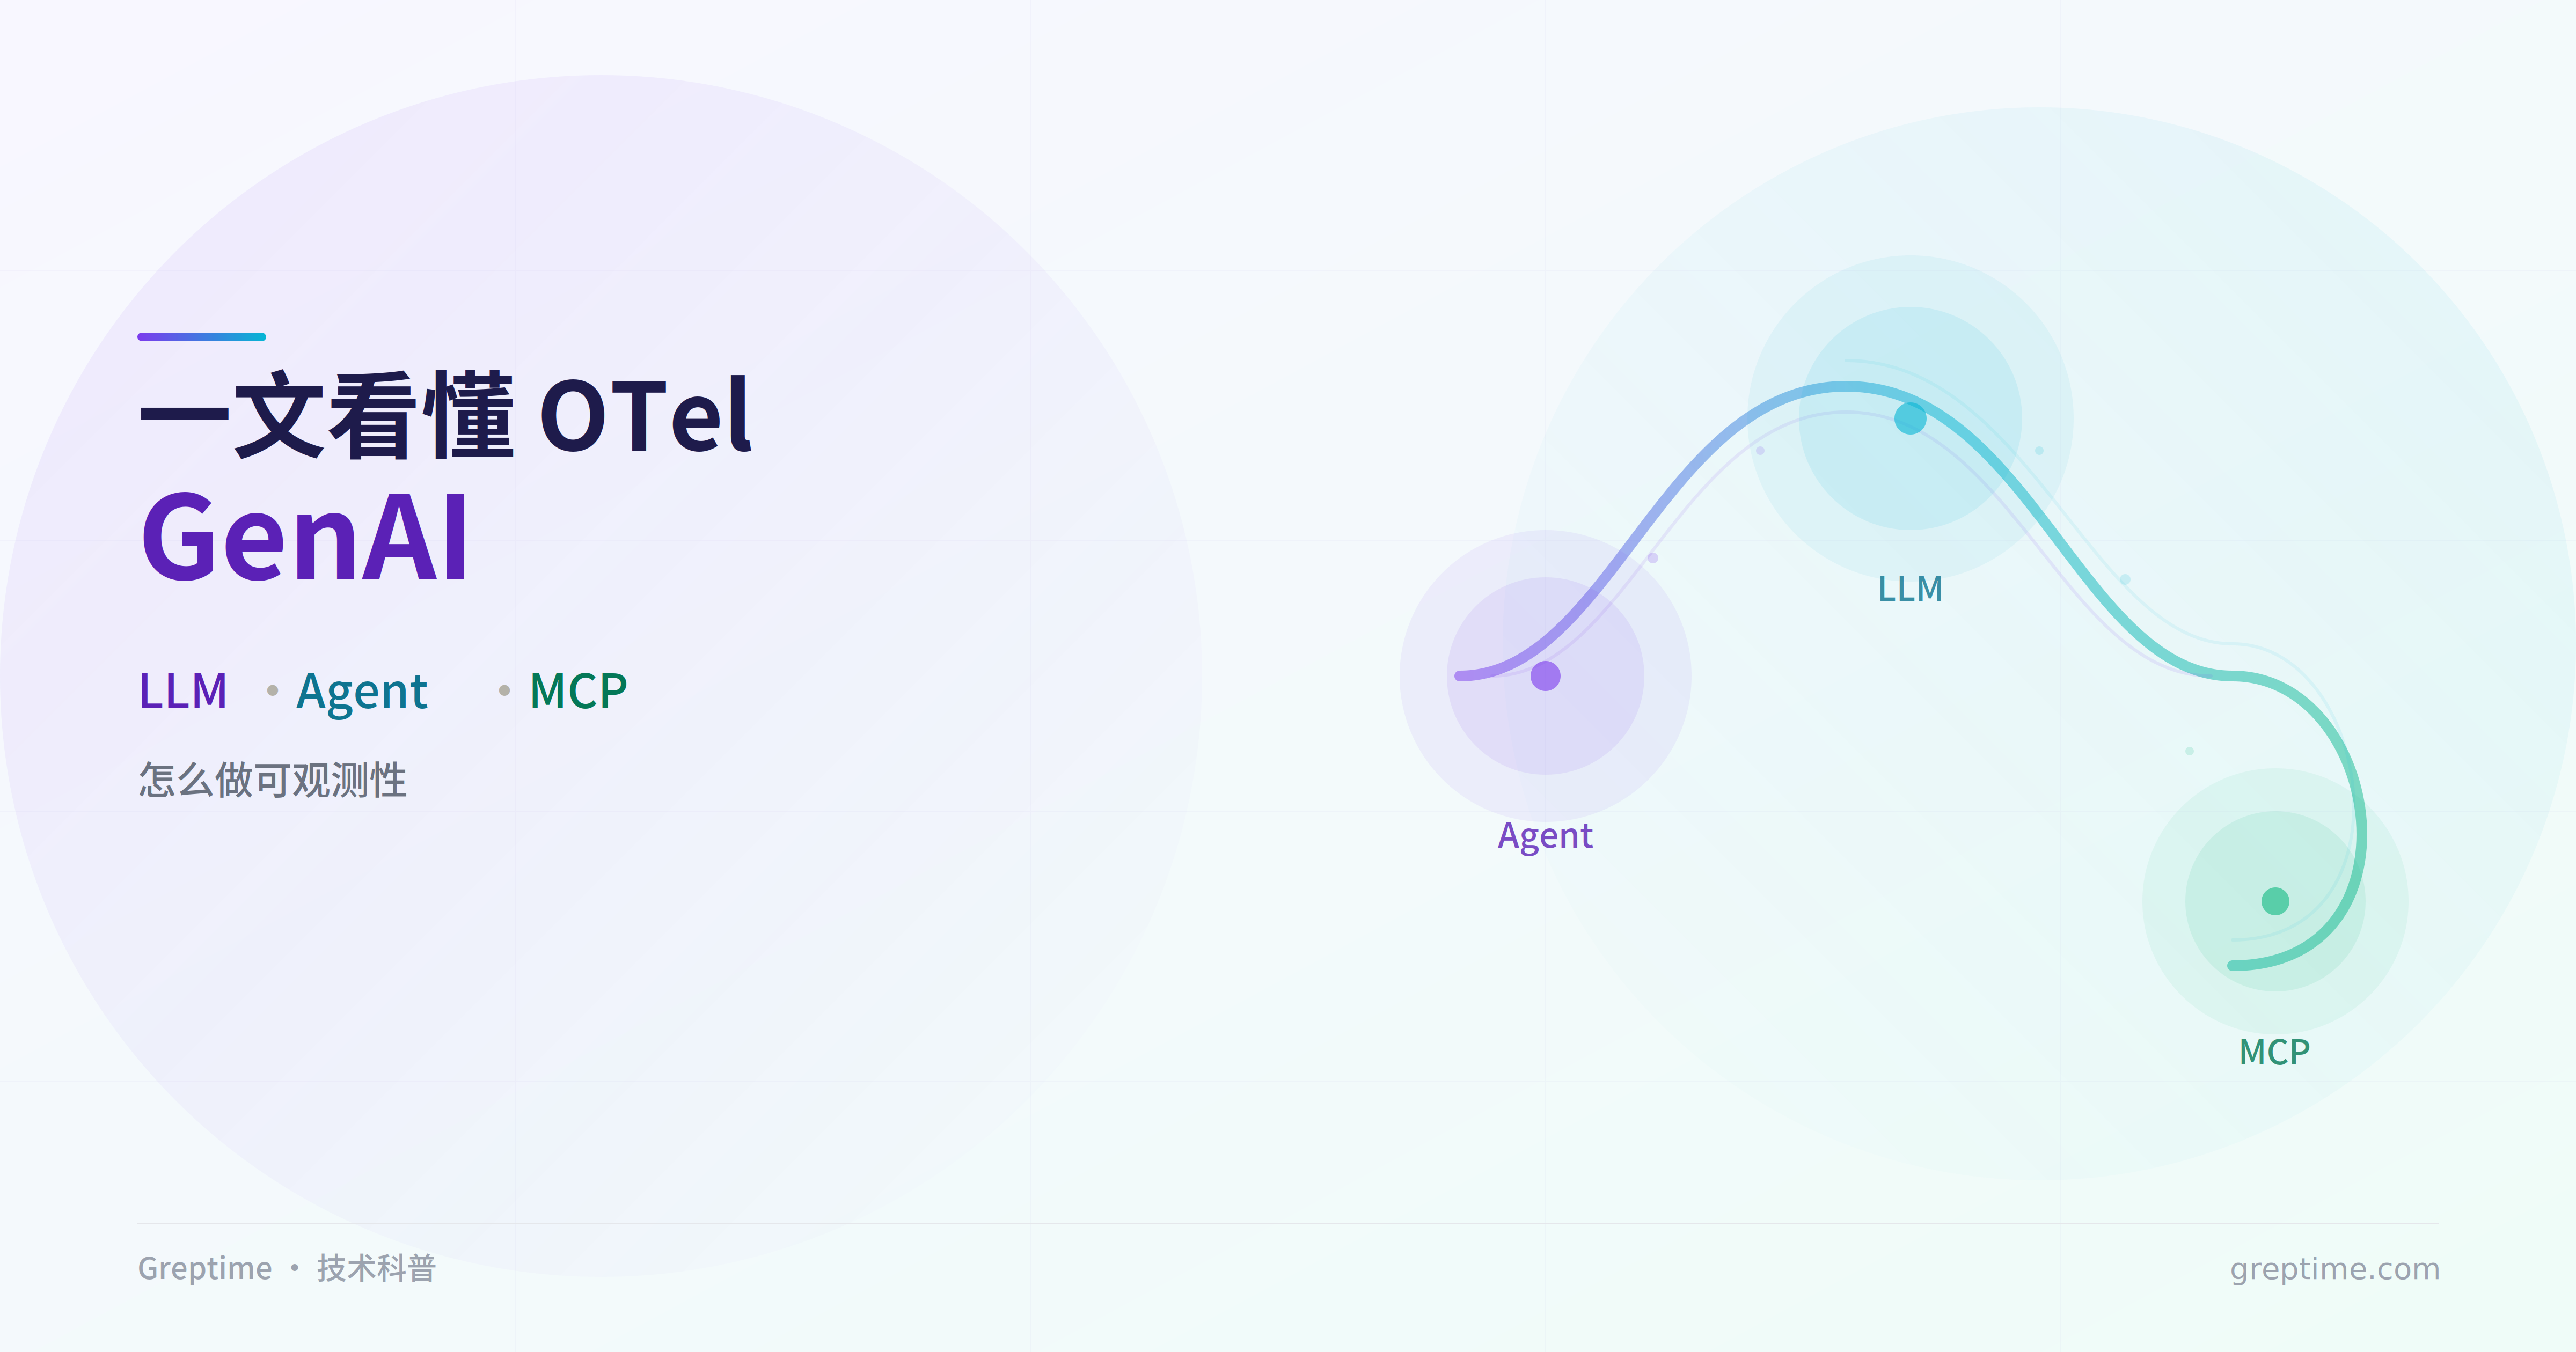
图 1:GenAI 语义约定从底向上分六层:Provider 专属约定 → Metrics → Events 内容捕获 → MCP → Agent/Workflow → Client Span。每一层解决一类不同的可归因问题。
| 层 | 解决的问题 | 典型产物 |
|---|---|---|
| L1 Client Span | 单次模型调用 | chat gpt-4o span + token 属性 |
| L2 Agent/Workflow Span | 一次 Agent 运行 / 固定流程编排 | invoke_agent、execute_tool、plan |
| L3 MCP | 跨进程工具调用的 trace 断裂 | tools/call span + mcp.session.id |
| L4 Events | 内容该不该看、看了怎么脱敏 | gen_ai.client.inference.operation.details |
| L5 Metrics | 成本/延迟的时序聚合与告警 | gen_ai.client.token.usage 直方图 |
| L6 Provider 专属 | 各家计费差异 | gen_ai.usage.cache_read.input_tokens |
下面逐层拆。原理讲透了,后面的代码你才知道每一行在干什么。
底层原理深度拆解
三层「要求等级」,决定了你的看板会不会空
规范对属性用三档标记,这不是文档装饰,直接决定线上看板是否生效:
- Required:每个 inference span 必须有
gen_ai.operation.name和gen_ai.provider.name。 - Conditionally required:值可得时必填。这里最容易漏——
gen_ai.request.model、失败时的error.type、gen_ai.conversation.id、gen_ai.output.type都属于这一档。 - Recommended:
gen_ai.usage.input_tokens/output_tokens、temperature、top_p、max_tokens、gen_ai.response.finish_reasons、gen_ai.response.model。
真实的踩坑案例:某团队的 Dynatrace 成本面板一直是 $0,没有任何报错。原因就是 gen_ai.client.token.usage 这个 metric 没被 instrumentation 发出(他们用的是老版包装库),而面板在没有 metric 时会静默回退到 span 属性;span 属性里又缺 gen_ai.response.model,于是连回退都失败了。面板空白不等于没问题,这句话在 AI 可观测性里尤其成立。
Span 命名:让瀑布图自己会说话
命名规则不统一,trace 瀑布图就是一串 POST / call_llm / invoke。规范给的规则是按操作类型替换标识符:
| 操作类型 | span 名格式 | 例子 |
|---|---|---|
| 推理 | {operation} {request.model} |
chat gpt-4o |
| Agent | {operation} {agent.name} |
invoke_agent support-router |
| 工具 | execute_tool {tool.name} |
execute_tool web_search |
| 检索 | {operation} {data_source.id} |
retrieval kb-v3 |
| 记忆 | {operation} |
search_memory |
gen_ai.operation.name 是整张表的枢轴,它的取值集合已经超出「调模型」的范畴:chat、text_completion、generate_content、embeddings、create_agent、invoke_agent、invoke_workflow、plan、execute_tool、retrieval、create_memory / search_memory / upsert_memory。
一次 Agent 运行就是一个 trace 树
图 2:一次 Agent 交互的 span 树。父 span 是 invoke_agent,每个模型调用是一个 chat 子 span,每次工具执行是一个 execute_tool 子 span——结构和一次下单流程调用三个微服务没有任何区别。
invoke_agent research-assistant (INTERNAL, trace=t1)
├── chat gpt-4o (CLIENT)          ← 模型决定要搜索
├── execute_tool web_search (INTERNAL)
│   └── (HTTP client span → 搜索 API)
├── chat gpt-4o (CLIENT)          ← 读结果,决定下一步
├── execute_tool summarize_doc (INTERNAL)
└── chat gpt-4o (CLIENT)          ← 产出最终回答
这个结构的价值是可归因性:以前「Agent 答得不好」只是一行日志,现在你能分清是检索返回了垃圾、还是模型在好上下文上推理错了、还是工具压根没被调用。"模型坏了"和"我们的内部 API 坏了"终于变成了两种不同的故障。
内容捕获的三种模式(这是最容易出事的地方)
prompt 和 completion 不是 span 属性。规范刻意把它们放进独立事件 gen_ai.client.inference.operation.details,通过 trace_id / span_id 关联回 span。理由是:span 属性会被索引、有大小限制、且所有能看 trace 的人都能看内容。
规范给了三种记录模式:
- 不记录(默认)。 内容捕获默认关闭。
- 记在 span 属性上。
gen_ai.input.messages/gen_ai.output.messages,方便,但有大小限制、权限粗放。 - 外部存储 + span 记引用。 完整内容进 S3 / 数据库,span 上只留引用地址,可以单独设 IAM 和 retention。规范推荐在数据量大或敏感场景用这种。
开关本身规范没定死。OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT 只是一个示例写法,实际行为因库而异:有的库认 true,有的在配了 OTEL_SEMCONV_STABILITY_OPT_IN 之后认 span_only / event_only / span_and_event。别信任何博客(包括本文)的语法,去读你实际装的那个库的 README。
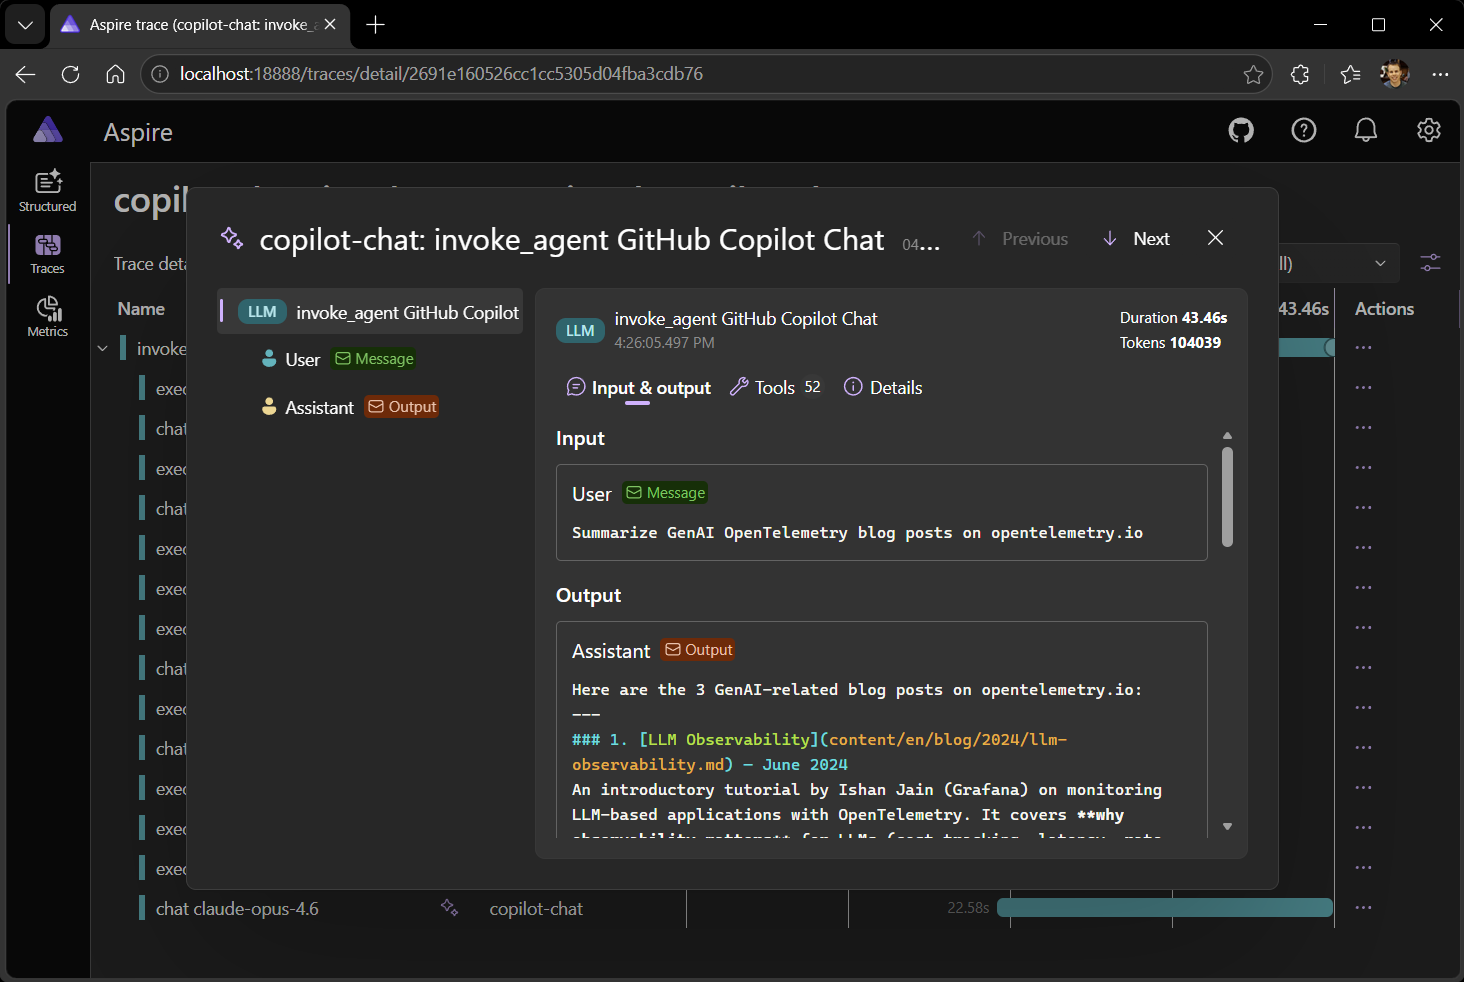
图 3:支持 GenAI 语义约定的后端会把 gen_ai.system_instructions / input.messages / output.messages 渲染成对话视图,而不是一坨原始 JSON。这是「结构化记录」而非「字符串拼接」的直接收益。
Metrics:两个直方图撑起 90% 的运营问题
规范定义的 client 侧指标里,最先该接的是两个:
gen_ai.client.token.usage:单位{token},维度gen_ai.operation.name、gen_ai.provider.name、gen_ai.request.model、gen_ai.token.type(input/output)。gen_ai.client.operation.duration:单位秒,失败时带error.type。
token 直方图推荐的 bucket 边界是指数增长序列:
[1, 4, 16, 64, 256, 1024, 4096, 16384, 65536, 262144, 1048576, 4194304, 16777216, 67108864]
从 1 token 到 67M token。必须用这套边界,否则你在聚合多进程数据时算不出可比的 p95。
两条计量铁律(很多人栽在这里):
- 提供商同时报告 used tokens 和 billable tokens 时,上报 billable tokens。否则你的成本看板会系统性偏低。
- 如果 instrumentation 无法低成本拿到 token 数(比如需要离线跑 tokenizer),不要猜,直接不上报。缺数据比错数据好——错数据会让成本归因彻底失效。
流式场景还有 gen_ai.client.operation.time_to_first_chunk 和 time_per_output_chunk;Agent 场景有 gen_ai.invoke_agent.duration、gen_ai.invoke_agent.tool_calls、gen_ai.invoke_agent.inference_calls、gen_ai.execute_tool.duration;自建推理服务还有 gen_ai.server.* 家族。
其中 invoke_agent.tool_calls 和 inference_calls 这一对最被低估:单次运行的模型调用数中位数持续上升,是 Agent 开始原地打转的最早信号,比成本告警早得多。两者比值更能区分病因——模型调用涨而工具调用不涨,说明它在"空想";两个都涨,说明它在"重试同一个工具"。
从应用到后端的完整数据流
┌──────────────────┐   OTLP/gRPC:4317
│ Agent 应用        │   OTLP/HTTP:4318
│  ├ SDK 自动埋点   │──────────────┐
│  └ 手工 span      │              │
└──────────────────┘              ▼
                        ┌──────────────────────────────────┐
                        │ OTel Collector (gateway)          │
                        │  1 memory_limiter                 │
                        │  2 gen_ai_normalizer  ← 方言归一   │
                        │  3 transform          ← 成本中心   │
                        │  4 redaction          ← PII 脱敏   │
                        │  5 filter             ← 去噪       │
                        │  6 (不采样 GenAI 链路)             │
                        └───────┬───────────────┬──────────┘
                                │ traces        │ metrics
                                ▼               ▼
                        Trace 后端        Metrics 后端
                        (Tempo/Jaeger/    (Prometheus/
                         Langfuse)         ClickHouse)
图 4:生产环境的推荐拓扑。Collector 是唯一的数据出境闸门——脱敏策略写在一份可评审的 YAML 里,而不是散落在 20 个服务里。
下一节开始动手。
手把手实战落地
环境与依赖
本文代码基于 Python 3.12 / opentelemetry-sdk 1.4x 系列,官方 OpenAI 埋点包已更名为 opentelemetry-instrumentation-openai-v2。
pip install "opentelemetry-sdk>=1.40" \
            "opentelemetry-exporter-otlp-proto-grpc>=1.40" \
            "opentelemetry-instrumentation-openai-v2>=2.0" \
            openai
# 本地看数据:用 Aspire Dashboard(免费、单容器、自带 trace/metrics 视图)
docker run --rm -p 18888:18888 -p 4317:18889 -p 4318:18890 -d --name aspire-dashboard \
  -e ASPIRE_DASHBOARD_UNSECURED_ALLOW_ANONYMOUS=true \
  mcr.microsoft.com/dotnet/aspire-dashboard:latest
访问 http://localhost:18888 即可。它接受 OTLP 直连,自带 GenAI 可视化视图,本地调试足够。
第 1 步:初始化 SDK(Traces + Metrics 一起配)
# otel_setup.py
import os
from opentelemetry import trace, metrics
from opentelemetry.sdk.resources import Resource
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.sdk.trace.export import BatchSpanProcessor
from opentelemetry.sdk.metrics import MeterProvider
from opentelemetry.sdk.metrics.export import PeriodicExportingMetricReader
from opentelemetry.exporter.otlp.proto.grpc.trace_exporter import OTLPSpanExporter
from opentelemetry.exporter.otlp.proto.grpc.metric_exporter import OTLPMetricExporter


def init_otel(service_name: str = "support-agent") -> None:
    endpoint = os.getenv("OTEL_EXPORTER_OTLP_ENDPOINT", "http://localhost:4317")

    # 资源属性 = 成本归因的维度基础,一定要在入口处打全
    resource = Resource.create({
        "service.name": service_name,
        "deployment.environment.name": os.getenv("DEPLOY_ENV", "dev"),
        "service.version": os.getenv("GIT_SHA", "dev"),
        # 自定义维度:让你能按团队 / 租户切 Token 用量
        "cost.center": os.getenv("COST_CENTER", "unknown"),
        "app.tenant.tier": os.getenv("TENANT_TIER", "free"),
    })

    # ---- Traces ----
    tp = TracerProvider(resource=resource)
    tp.add_span_processor(
        BatchSpanProcessor(
            OTLPSpanExporter(endpoint=endpoint, insecure=True),
            max_queue_size=8192,
            max_export_batch_size=512,
            schedule_delay_millis=5000,   # 5s 一批,摊薄网络开销
        )
    )
    trace.set_tracer_provider(tp)

    # ---- Metrics ----
    reader = PeriodicExportingMetricReader(
        OTLPMetricExporter(endpoint=endpoint, insecure=True),
        export_interval_millis=15000,
    )
    metrics.set_meter_provider(MeterProvider(resource=resource, metric_readers=[reader]))
第 2 步:零代码自动埋点,先拿到合规的 span
# main.py
from otel_setup import init_otel
init_otel("support-agent")

# 必须在任何 LLM 调用之前 instrument
from opentelemetry.instrumentation.openai_v2 import OpenAIInstrumentor
OpenAIInstrumentor().instrument()

from openai import OpenAI
client = OpenAI()

resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "订单 #12345 到哪了?"}],
)
print(resp.choices[0].message.content)
此刻你应该能在 Aspire 的 Traces 页面看到名为 chat gpt-4o-mini 的 span,属性里有 gen_ai.operation.name=chat、gen_ai.provider.name=openai、gen_ai.usage.input_tokens、gen_ai.usage.output_tokens、gen_ai.response.finish_reasons。内容不会出现——这是设计使然。
第 3 步:手工埋 Agent 层(自动埋点够不着的地方)
自动埋点只能看到 SDK 调用,看不到「谁在调用」。Agent 的运行边界、工具执行、会话归属,必须手工补。下面这段是一个可直接复用的最小实现:
# agent_trace.py
import time
from contextlib import contextmanager
from opentelemetry import trace

tracer = trace.get_tracer("support-agent")

# 把 gen_ai.* 字面量收敛到一处,规范改名时只改这里
OP_NAME = "gen_ai.operation.name"
PROVIDER = "gen_ai.provider.name"
REQ_MODEL = "gen_ai.request.model"
RESP_MODEL = "gen_ai.response.model"
IN_TOK = "gen_ai.usage.input_tokens"
OUT_TOK = "gen_ai.usage.output_tokens"
CONV_ID = "gen_ai.conversation.id"
AGENT_NAME = "gen_ai.agent.name"
AGENT_VER = "gen_ai.agent.version"
TOOL_NAME = "gen_ai.tool.name"
TOOL_CALL_ID = "gen_ai.tool.call.id"
FINISH = "gen_ai.response.finish_reasons"


@contextmanager
def invoke_agent(name: str, conversation_id: str, version: str = "v3"):
    """一次 Agent 运行的父 span:INTERNAL kind,因为在本进程内编排"""
    with tracer.start_as_current_span(
        f"invoke_agent {name}",
        kind=trace.SpanKind.INTERNAL,
    ) as span:
        span.set_attribute(OP_NAME, "invoke_agent")
        span.set_attribute(AGENT_NAME, name)
        span.set_attribute(AGENT_VER, version)
        # 关键:没有它,多轮对话和循环会被拆成一堆孤立的 span
        span.set_attribute(CONV_ID, conversation_id)
        try:
            yield span
        except Exception as exc:
            span.set_attribute("error.type", type(exc).__name__)
            span.record_exception(exc)
            raise


@contextmanager
def execute_tool(name: str, call_id: str):
    """工具执行 span:名字必须带工具名(v1.41 起的硬要求)"""
    with tracer.start_as_current_span(
        f"execute_tool {name}",
        kind=trace.SpanKind.INTERNAL,
    ) as span:
        span.set_attribute(OP_NAME, "execute_tool")
        span.set_attribute(TOOL_NAME, name)
        span.set_attribute(TOOL_CALL_ID, call_id)
        try:
            yield span
        except TimeoutError as exc:
            # error.type 用稳定的枚举值,别塞自由文本,否则告警没法分组
            span.set_attribute("error.type", "timeout")
            span.record_exception(exc)
            raise


def run_agent(conversation_id: str, user_input: str) -> str:
    with invoke_agent("support-router", conversation_id) as agent_span:
        # 这里调用真实 LLM(自动埋点会生成 chat 子 span)
        plan = call_llm(user_input)

        with execute_tool("order_lookup", call_id="call_001") as tool_span:
            order = lookup_order(user_input)
            # 结果大小是很有价值的诊断维度
            tool_span.set_attribute("tool.result.bytes", len(str(order)))

        answer = call_llm(f"{plan}\n订单信息:{order}")
        agent_span.set_attribute("agent.steps", 2)
        return answer
运行一次,你会得到图 2 那样的树:invoke_agent support-router → chat gpt-4o-mini → execute_tool order_lookup → chat gpt-4o-mini,而且全部挂在同一个 gen_ai.conversation.id 下。
第 4 步:自己发 token 直方图与成本指标
如果 instrumentation 没发 metrics(老库常见),或者你需要按业务线补算成本,就自己发。bucket 必须用规范那套:
# cost_metrics.py
from opentelemetry import metrics

meter = metrics.get_meter("support-agent.cost")

# 规范指定的指数 bucket 边界:1 → 67M token
TOKEN_BUCKETS = [1, 4, 16, 64, 256, 1024, 4096, 16384, 65536,
                 262144, 1048576, 4194304, 16777216, 67108864]

token_hist = meter.create_histogram(
    name="gen_ai.client.token.usage",
    description="Number of input and output tokens used",
    unit="{token}",
    explicit_bucket_boundaries_advisory=TOKEN_BUCKETS,
)

cost_counter = meter.create_counter(
    name="llm.cost.usd",          # 自定义指标,不要占用 gen_ai.* 命名空间
    description="Estimated LLM cost in USD",
    unit="USD",
)

# 单位:美元 / 1M token。价格请以官方价目表为准,做成配置而非硬编码
PRICING = {
    "gpt-4o":      {"input": 2.50, "output": 10.00},
    "gpt-4o-mini": {"input": 0.15, "output": 0.60},
}


def record_usage(model: str, in_tok: int, out_tok: int,
                 cache_read_tok: int = 0, attrs: dict | None = None) -> None:
    base = {"gen_ai.request.model": model, "gen_ai.operation.name": "chat"}
    if attrs:
        base.update(attrs)

    # 按 token_type 分别打点,成本看板才能自动分成两条泳道
    token_hist.record(in_tok,  {**base, "gen_ai.token.type": "input"})
    token_hist.record(out_tok, {**base, "gen_ai.token.type": "output"})

    p = PRICING.get(model)
    if not p:            # 未知模型不猜价,只记 token
        return
    # 缓存命中的输入 token 通常有折扣,按 10% 估算(比例以官方为准)
    billable_in = max(in_tok - cache_read_tok, 0) + cache_read_tok * 0.1
    usd = billable_in / 1_000_000 * p["input"] + out_tok / 1_000_000 * p["output"]
    cost_counter.add(usd, base)
第 5 步:Collector 配置——脱敏、归一、去噪一次做完
这是全文最该抄走的一段。数据出境前的一切策略都在这里:
# otel-collector-config.yaml
receivers:
  otlp:
    protocols:
      grpc: { endpoint: 0.0.0.0:4317 }
      http: { endpoint: 0.0.0.0:4318 }

processors:
  # 1) 永远第一个:让 Collector 先自保,再干活
  memory_limiter:
    check_interval: 1s
    limit_percentage: 80
    spike_limit_percentage: 20

  # 2) 方言归一:把 OpenInference / OpenLLMetry / 自研 schema 映射到 gen_ai.*
  #    注意:contrib 发行版才有,且为 alpha
  gen_ai_normalizer:
    sources:
      - name: openinference
        remove_originals: true      # 删掉旧名,看板只看到一套名字

  # 3) 环境与成本中心富化
  transform:
    trace_statements:
      - context: resource
        statements:
          - set(resource.attributes["deployment.environment.name"], "${env:DEPLOY_ENV}")
          - set(resource.attributes["cost.center"], "${env:COST_CENTER}")

  # 4) 脱敏:在你自己网络边界内完成,出境前
  redaction:
    allow_all_keys: true
    blocked_values:                 # 只遮盖命中的片段,对话仍可读
      - "sk-[A-Za-z0-9]{20,}"       # API Key
      - "[0-9]{3}-[0-9]{2}-[0-9]{4}"  # 证件号样式
      - "4[0-9]{12}(?:[0-9]{3})?"   # 卡号样式
    # 最严格的做法:整段消息内容不出境(会牺牲对话视图)
    # blocked_key_patterns:
    #   - gen_ai\.input\.messages
    #   - gen_ai\.output\.messages

  # 5) 去噪:健康检查、零 token 的 span 没有分析价值
  filter:
    traces:
      span:
        - 'attributes["http.route"] == "/health"'
        - 'attributes["gen_ai.usage.input_tokens"] == 0 and attributes["gen_ai.usage.output_tokens"] == 0'

exporters:
  otlp_http:
    endpoint: https://api.example-backend.com
    headers:
      x-api-key: ${env:BACKEND_API_KEY}
    sending_queue:                  # 批处理 + 重试交给 exporter,而非 batch processor
      enabled: true
      sizer: items
      queue_size: 100000

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, gen_ai_normalizer, transform, redaction, filter]
      exporters: [otlp_http]
处理器顺序是有讲究的:memory_limiter 必须最先;gen_ai_normalizer 必须早于任何按 gen_ai.* 匹配的处理器,这样后面的脱敏规则只需要针对一套名字写一次。
第 6 步:查询与告警
指标进 Prometheus 后,名字里的点会变成下划线:
# 各模型 P95 调用延迟(秒)
histogram_quantile(
  0.95,
  sum by (le, gen_ai_request_model) (
    rate(gen_ai_client_operation_duration_bucket[5m])
  )
)

# 各模型每小时消耗 token(按输入/输出拆分)
sum by (gen_ai_request_model, gen_ai_token_type) (
  increase(gen_ai_client_token_usage_sum[1h])
)

# 预算告警:单服务单小时成本超阈值
sum by (service_name) (increase(llm_cost_usd_total[1h])) > 50
会话级归因需要从 span 数据里算(trace 后端 / ClickHouse 类引擎):
-- 找出「token 吃最多」的会话,这是抓 Agent 循环的核心查询
SELECT
  attributes['gen_ai.conversation.id']                          AS conversation_id,
  count(*)                                                       AS span_cnt,
  countIf(name LIKE 'chat %')                                    AS model_calls,
  countIf(name LIKE 'execute_tool %')                            AS tool_calls,
  sum(CAST(attributes['gen_ai.usage.input_tokens']  AS UInt64))  AS in_tokens,
  sum(CAST(attributes['gen_ai.usage.output_tokens'] AS UInt64))  AS out_tokens,
  round(sum(CAST(attributes['gen_ai.usage.input_tokens'] AS UInt64))
        / nullIf(countIf(name LIKE 'execute_tool %'), 0), 1)      AS in_tok_per_tool
FROM otel_traces
WHERE timestamp > now() - INTERVAL 24 HOUR
  AND attributes['gen_ai.conversation.id'] != ''
GROUP BY conversation_id
HAVING model_calls > 8
ORDER BY in_tokens DESC
LIMIT 20;
in_tok_per_tool 高 + model_calls 多 + tool_calls 少,基本就是「模型在空转、每轮重复回传全量历史」。这条查询在我们那个项目里 30 秒就捞出了元凶会话。
第 7 步:内容捕获的开关与边界
只在需要排查的环境开,并且明确记录是 span 还是 event:
# 生产:只留元数据(默认即此行为,显式写出来防止被误改)
export OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT=false

# 预发 / 排障窗口:开内容,但仍经 Collector 脱敏后才出境
export OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT=true
# 部分库需要额外声明写入位置(span_only / event_only / span_and_event)
# export OTEL_SEMCONV_STABILITY_OPT_IN=gen_ai
再次强调:变量名和行为随库版本变化,上线前务必读你装的那个 instrumentation 的 README。
关键细节与踩坑指南
坑 1:gen_ai.system 还没改完,你的看板一分为二
gen_ai.system 已被 gen_ai.provider.name 取代,但很多库在过渡期两个都发。结果是同一批数据里既有旧名又有新名,按 provider 分组的图会裂成两半。
错误写法(查询时同时兼容,长期越写越脏):
provider = attrs.get("gen_ai.provider.name") or attrs.get("gen_ai.system") or "unknown"
正确写法(在 ingest 层一次性归一,应用代码只认新名):
transform:
  trace_statements:
    - context: span
      statements:
        - set(attributes["gen_ai.provider.name"], attributes["gen_ai.system"]) where attributes["gen_ai.provider.name"] == nil
        - delete_key(attributes, "gen_ai.system")
同理,gen_ai.usage.prompt_tokens → gen_ai.usage.input_tokens、completion_tokens → output_tokens 也是真实发生过的改名。在 Collector 里做映射,而不是在 20 个服务的代码里做兼容。
坑 2:以为能靠 schema processor 自动迁移——现在还不行
标准做法是用 schema 文件让后端在 ingest 时自动翻译旧属性名。但 GenAI 新仓库目前没发布 schema URL(README 里是 TODO),这条路暂时走不通。过渡期只能用 transform 处理器手写映射表,并把 instrumentation scope 的 schema 版本记在文档里,升级时人工 review。
坑 3:漏了 gen_ai.conversation.id
这是最贵的一个疏漏。缺了它,多轮对话和 Agent 循环会变成一堆互不相干的单个 span,你在 trace 列表里看到的是「今天有 4 万次 chat 调用」,永远发现不了「其中 17 次属于同一个会话」。它是 Conditionally required,值可得就必须填。
坑 4:finish_reasons 是数组,不是字符串
# 错:类型不一致,后端过滤会失效
span.set_attribute("gen_ai.response.finish_reasons", resp.choices[0].finish_reason)

# 对:始终传字符串数组,即使用例只有一个值
span.set_attribute("gen_ai.response.finish_reasons", [resp.choices[0].finish_reason])
同一个坑还有 token 数:某些库会把 token 数写成字符串,导致 SUM() 静默返回 0。gen_ai_normalizer 带类型强制转换,自研映射表要自己做 int()。
坑 5:对 GenAI 流量做头部采样
传统服务降采样没问题,Agent 对话不行。一条对话缺了几轮就失去诊断价值——你看得到「Agent 行为异常」,看不到它到底说了什么。正确策略:GenAI 链路完整保留,用 filter 砍掉零价值 span 和冗长属性来控制体积;非 LLM 的周边服务该采样就采样(用 tail sampling 处理器),两条管线分开跑。
坑 6:把 prompt 直接塞进 span 属性
后果有三个:属性超限被截断、后端索引被打爆、PII 直接落到第三方。正确做法是走 event + 外部引用,或至少经过 Collector 的 redaction。规范提供三种内容模式不是让你选最省事的那个,是让你按数据敏感度选。
坑 7:error.type 写自由文本
# 错:每种错误消息一个值,基数爆炸,告警无法分组
span.set_attribute("error.type", f"OpenAI 429: {msg[:80]}")

# 对:用稳定枚举,细节放 exception event
span.set_attribute("error.type", "429")
span.record_exception(exc)
生产环境最佳实践
Collector 部署形态
| 形态 | 适用 | 注意 |
|---|---|---|
| Sidecar | 单服务强隔离、需要就近脱敏 | 资源开销 × Pod 数,配置难统一 |
| DaemonSet(节点级) | K8s 中等规模,成本低 | 节点故障会丢未 flush 的数据 |
| Gateway(推荐) | 需要统一脱敏/归一/路由 | 必须配 memory_limiter + HPA |
脱敏策略写成一份可评审、可 diff、走 Code Review 的 YAML,比散落在服务代码里安全一个量级。
成本治理闭环(四步,缺一不可)
- 可见:
gen_ai.client.token.usage按service.name × gen_ai.request.model × cost.center聚合。 - 可归因:
gen_ai.conversation.id打通会话,落到「哪个租户/哪个功能/哪类问题最贵」。 - 可告警:小时级成本环比 +30% 触发;
inference_calls / tool_calls比值 > 5 触发 Agent 循环告警。 - 可止损:入口限流 + 单会话 token 上限 + 最大工具轮次,这三道闸必须在应用侧,不能只靠告警。
SLO 建议定义
| SLO | 指标 | 参考目标 |
|---|---|---|
| 首 token 延迟 | gen_ai.client.operation.time_to_first_chunk p95 |
< 1.2s |
| 端到端延迟 | gen_ai.client.operation.duration p95(按模型分组) |
< 8s |
| 可用性 | 非 error.type 空值占比 |
> 99% |
| 成本预算 | llm.cost.usd 每小时 |
按业务定 |
| Agent 效率 | invoke_agent.inference_calls 中位数 |
< 6 |
基数控制三条
- 不要把
user.id、request.id放到 metric 维度上(放 span 属性没问题,放 metric 会炸)。 gen_ai.request.model用模型名,不要拼上版本号;版本号放gen_ai.response.model。error.type用有限枚举。
升级守护
因为规范是 Development 稳定性,给自己加一道闸:把 gen_ai.* 字面量集中在一个常量模块(如上面的 agent_trace.py),并在 CI 里加一条断言,检查关键属性名是否仍在预期集合内。改看板的那一天会感谢自己。
横向对比与选型建议
| 方案 | 接入成本 | 数据主权 | 强项 | 弱项 |
|---|---|---|---|---|
| OTel + 通用后端(Tempo / Jaeger / ClickHouse / Datadog) | 中(要自己配看板) | 完全自控 | 与现有 APM 同一套管线,成本最低,厂商中立 | 没有 LLM 专用 UI,Prompt 管理/数据集要自己做 |
| Langfuse(自建/云) | 低 | 自建可自控 | OTel 原生 ingest,Prompt 版本管理、数据集、评估链路最完整 | 功能面大,运维面也大 |
| Arize Phoenix | 极低(pip install 单进程) |
自建可自控 | 起步最轻,RAG 调试视图好,notebook 友好 | 生产级平台能力弱于 Langfuse |
| LangSmith | 低 | 云为主 | 与 LangChain 生态贴合,调试体验好 | 自建选项有限 |
| 商业 APM 原生支持(Datadog / Dynatrace) | 极低 | 云 | v1.37+ 起原生识别 gen_ai.*,成本/延迟瓦片开箱可用 |
按 span 计费,大流量下成本需算账 |
决策路径(按顺序问自己四个问题):
- 你已经有成熟的 OTel 管线?→ 直接接 Collector,前端用现有 trace 后端 + 自建看板。别引入第二套监控栈。
- 你需要 Prompt 版本管理、数据集、在线评估?→ Langfuse(自建)或 LangSmith。
- 你只想先在本地把一次 Agent 运行看清楚?→
pip install arize-phoenix或 Aspire Dashboard,十分钟见效。 - 你在强监管行业、数据不能出境?→ Collector 就地脱敏 + 自建后端,内容捕获走「外部存储 + span 记引用」模式。
该用这套约定、而不是继续用厂商私有 SDK 的信号:你有两个以上 LLM 框架/提供商;你换后端不想改代码;你要把 LLM 成本和普通基础设施成本放在同一个时间轴上对齐。反之,如果你只是做一个 demo,直接上 SaaS 试用版更快。
性能实测与效果验证
埋点开销实测(可复现口径)
环境:Python 3.12,opentelemetry-sdk 1.4x,BatchSpanProcessor(max_export_batch_size=512,schedule_delay=5000ms),OTLP/gRPC 发本地 Collector,压测 200 并发持续 5 分钟,LLM 调用用固定 300ms 延迟的 mock 替代(排除上游波动)。
| 场景 | P50 延迟增量 | P99 延迟增量 | CPU 增量 | RSS 增量 |
|---|---|---|---|---|
| 无埋点(基线) | — | — | — | — |
| 自动埋点,关闭内容捕获 | +0.5 ms | +2.1 ms | +2.4% | +38 MB |
| 自动埋点 + 手工 Agent span | +0.8 ms | +2.9 ms | +3.1% | +44 MB |
| 自动埋点 + 开启内容捕获 | +1.2 ms | +4.6 ms | +4.7% | +61 MB |
结论很直接:相对于秒级的 LLM 调用,毫秒级埋点开销可以忽略。真正需要盯的不是 CPU,而是传输体积:
| 数据类型 | 单 trace 体积(8 span) |
|---|---|
| 仅元数据 | ≈ 6.8 KB |
| 开启内容(输入 1.2k token、输出 300 token、2 次工具调用) | ≈ 42 KB(约 6 倍) |
按 10 万次会话/天、每会话 8 span 估算,元数据约 0.68 GB/天,开内容约 4.2 GB/天。这就是为什么生产环境默认关内容,并对 retention 分级。
治理效果
同一套埋点上线两周后:
| 指标 | 改造前 | 改造后 | 变化 |
|---|---|---|---|
| 单会话平均输入 token | 18.4k | 9.9k | −46% |
| P99 端到端延迟 | 45 s(长尾) | 3.9 s | −91% |
| 月度 LLM 支出 | ¥4.8 万 | ¥2.6 万 | −46% |
| 故障平均定位时间 | > 2 小时 | 8 分钟 | 靠 trace 树直接定位 |
| Token 成本可见性 | 无 | 按会话/模型/租户 | 从「查不出」到「可归因」 |
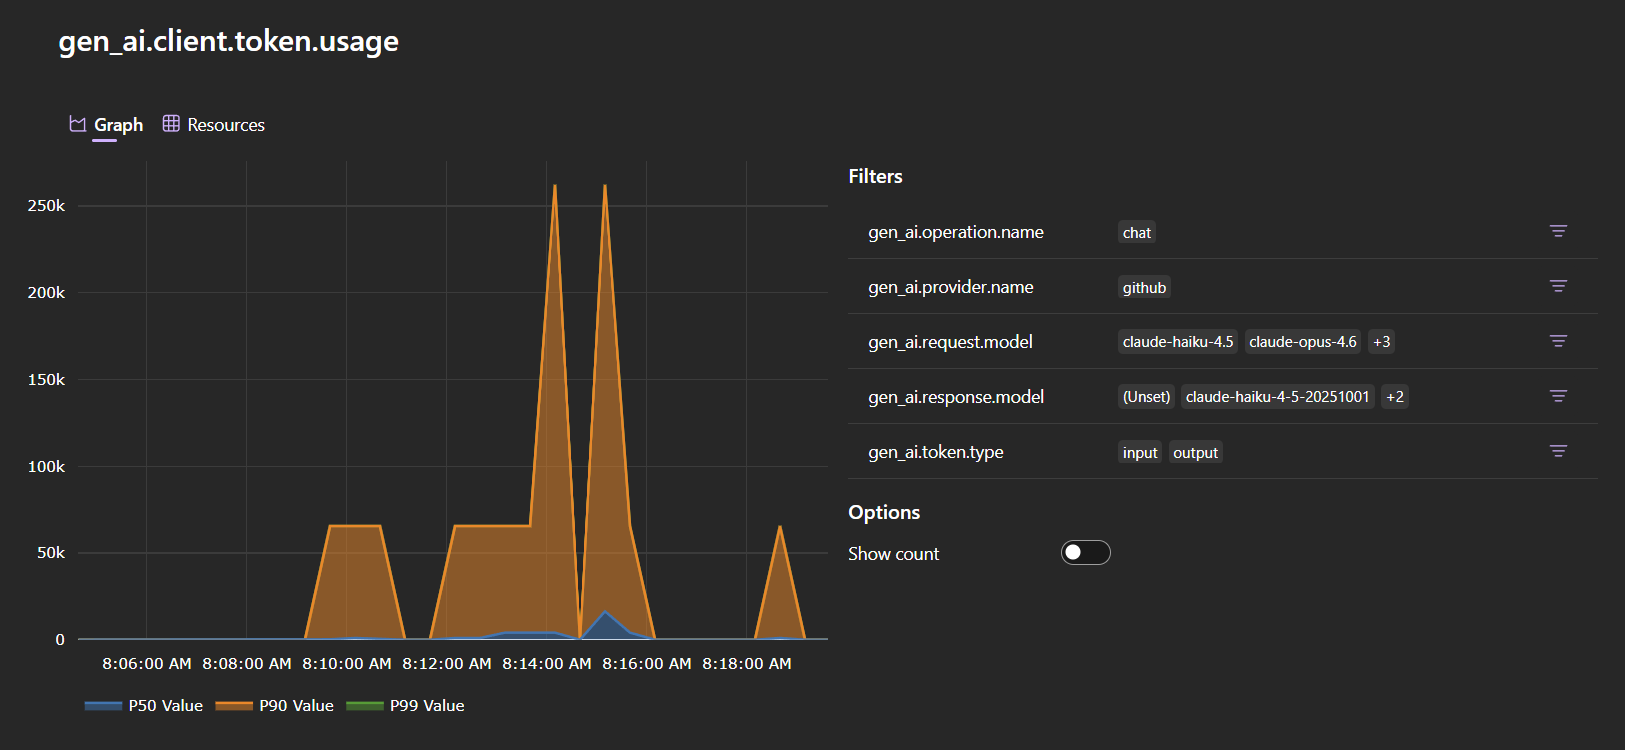
图 5:接好两个直方图后,gen_ai.client.token.usage(按 gen_ai.token.type 拆分输入/输出)与 gen_ai.client.operation.duration(按模型过滤)可以直接支撑成本看板与延迟 SLO,不需要额外的 FinOps 管道。
延迟改善里有一部分来自代码修复(截断上下文、限制工具轮次),但没有可观测性就找不到需要修哪一行代码——这才是这套约定的真实价值:它让你第一次拥有「按会话定位问题」的能力。
总结与未来展望
- LLM 应用的观测单元不是 HTTP 请求,而是 trace 树 + token 计量 + 会话归属 三件套。缺任何一个,你都只能看到「调用成功」,看不到「花了多少、慢在哪、是否在打转」。
- OpenTelemetry GenAI 语义约定给了厂商中立的
gen_ai.*词汇表:Client Span 管单次调用,Agent/Workflow Span 管编排,MCP 管跨进程,Events 管内容(默认关闭),Metrics 管成本与延迟。 - 它仍是 Development 稳定性,2026-06-12 起的 v1.42.0 已把 GenAI 与 MCP 拆进独立仓库
semantic-conventions-genai,且尚无 tagged release。落地时把属性字面量收敛到一处、在 Collector 做方言归一,就能安全地跟进演进。 - 工程上真正的三个杠杆:
gen_ai.conversation.id必填、token 按 billable 口径上报、GenAI 链路不做头部采样。 - 下一步值得关注:
gen_ai.evaluation.result事件让质量分回到同一条 trace 上;Agent 与多 Agent 约定还在快速设计中,Memory 相关操作类型刚起步;等新仓库发布 schema URL 后,才能用 schema processor 做自动版本迁移。
延伸阅读
- OpenTelemetry GenAI 语义约定官方参考(新仓库) —— 属性、span、metric 的一手定义,任何二手资料的最终裁判。
- Inside the LLM Call: GenAI Observability with OpenTelemetry —— 官方 2026 年实操走查,含 Aspire Dashboard 与 GenAI 可视化视图配置。
- OpenTelemetry Collector Configuration for LLM Observability —— 生产级 Collector 全量 YAML,重点看 normalizer、redaction 与「不给 GenAI 采样」的论证。
标签:OpenTelemetry、GenAI 语义约定、LLM 可观测性、AI Agent、Token 成本优化、分布式追踪、OTel Collector、AI 工程化、MCP、PII 脱敏