Agent 排障不再靠猜:OTel GenAI 语义约定追踪工程实战
当一次用户请求背后是 5 次模型调用、3 次工具调用和 2 次向量检索时,日志和
try/except已经救不了你——你需要一棵标准化、可移植的 span 树。
开篇:从一个真实业务场景说起
某客服 Agent 上线三周后,账单开始诡异地上涨:同样的日活,token 消耗涨了 2.8 倍;同时客诉里出现"答非所问"和"转了三圈还是没解决"两种新问题。运维打开 Grafana,HTTP 200、P99 延迟 8 秒、CPU 平稳,一切"健康"。开发去翻应用日志,只看到一条条孤立的 INFO: llm call finished,既不知道这次请求前面检索回了什么文档,也不知道模型为什么连续调了 6 次 query_order。
团队最终用三天时间手工加日志才定位到根因:检索层某次索引重建后,retrieval 召回的文档从 5 条掉到 2 条,模型为了"补齐信息"反复调工具,陷入"工具调用 → 信息不足 → 再调用"的低效循环——一个横跨检索层、编排层、模型层的复合故障,在传统 APM 里完全不可见。
这就是本文要解决的问题:给你的 LLM / Agent 应用装上一棵符合 OpenTelemetry GenAI 语义约定(Semantic Conventions for Generative AI)的 span 树,让"哪一层慢、哪一步贵、哪一次决策错"变成可查询的结构化数据,而不是靠猜。我们只讲这一个点——埋点契约怎么定、span 树怎么长、生产怎么采样与脱敏、成本怎么归因,一路做到能跑。
技术背景与核心概念扫盲
为什么传统 APM 在 LLM 应用上直接失效
传统可观测性建立在"确定性"假设上:同一输入产生同一输出,异常 = 异常栈 + 非 2xx 状态码。LLM 应用把这三个假设全打破了。
| 维度 | 传统微服务 | LLM / Agent 应用 |
|---|---|---|
| 延迟驱动因素 | CPU、I/O、网络、下游调用 | 输入 token 数、输出 token 数、模型规模、上下文长度 |
| 成本单位 | 请求数 / QPS | token 数(且输入输出单价常不同) |
| 典型失败模式 | 异常、超时、5xx | 幻觉、上下文溢出、工具误选、Agent 空转循环 |
| 调试核心证据 | 异常栈 + 请求参数 | 完整提示词 + 完成内容 + 中间推理链 + 检索结果 |
| 高危基数来源 | URL 中的用户 ID | 整段提示词被塞进 span 属性 |
注意最后一行:传统埋点最大的忌讳是把高基数字段放进 span 名或标签,而 LLM 应用天生就想把整段 prompt 塞进去。这正是 GenAI 语义约定把"内容捕获"设计成独立、默认关闭机制的原因,后面会详细拆。
语义约定(Semantic Conventions)到底在约定什么
语义约定是 OpenTelemetry 的"命名法":它规定某个操作应该产生什么名字的 span、哪些属性键、哪些指标名、哪些事件名。约定统一之后,LangChain 打的 span、裸 OpenAI SDK 打的 span、你自己写的 HTTP 封装打的 span,在同一个瀑布图里能对齐,同一个大盘能查,换后端不用改代码。
OpenTelemetry 在 2024 年 4 月成立 GenAI SIG(Special Interest Group),最初范围只是"LLM 客户端调用追踪",现在已经扩展到六层:模型调用、Agent 编排、MCP 工具调用、内容捕获、质量评估、异常。
这里有一个 2026 年必须知道的工程事实:GenAI 语义约定已经从主仓库拆出去了。它现在住在独立仓库 open-telemetry/semantic-conventions-genai(2026 年 5 月 5 日创建),而 opentelemetry.io/docs/specs/semconv/gen-ai/ 下面的旧页面虽然还能返回 200,但正文只剩一句"已迁移"的公告;属性注册表页面里每个 gen_ai.* 键的稳定性列也改成了"Moved to..."。所以你去查文档、跟着官方 instrumentation 包 README 里的链接点过去,很容易落到这个空壳页上——这是很多人第一次接触就踩的坑,也是本文所有属性名以仓库 docs/gen-ai/ 下的 Markdown(由 model/ 里的 YAML 生成)为准的原因。
版本演进:从 v1.37 到 v1.41 的六次结构性变化
GenAI 约定变更速度很快,理解这条演进线,才能理解为什么网上大量教程的字段是错的。
| 版本 | GenAI 关键变更 |
|---|---|
| v1.37 | 会话历史记录方式重构:一枚事件一条消息改为聚合属性 gen_ai.system_instructions / gen_ai.input.messages / gen_ai.output.messages;gen_ai.system 被 gen_ai.provider.name 取代 |
| v1.38 | 新增评估事件;工具定义与调用详情;invoke_agent 语义指导;embedding 维度属性;多模态 JSON schema |
| v1.39 | MCP(Model Context Protocol)语义约定落地,解决 Agent 侧与 MCP Server 侧 trace 断裂 |
| v1.40 | 新增 retrieval span;缓存 token 属性;Anthropic 输入 token 计算指引 |
| v1.41 | execute_tool 的 span 名必须带工具名;reasoning token 属性;invoke_workflow;流式指标;invoke_agent 拆分为 CLIENT / INTERNAL |
一个关键判断:截至 2026 年,GenAI 仓库里所有文档仍标记 Status: Development,仓库没有打任何 tag,CHANGELOG.md 只有一个 ## Unreleased 标题——也就是说你能引用的参照物是某个 commit,而不是某个版本号。但这不等于不能用:借用自核心约定的属性是 Stable 的(error.type、server.address、server.port、exception.* 等都来自 semconv v1.43.0),传输与 API 机制(OTLP、Trace API、Telemetry Schema 机制)也是 Stable 的。在流动的是"GenAI 词汇表",不是承载它的机器。
所以正确的工程姿势不是"等它稳定",而是:按它会变来建。具体做法在"踩坑指南"里给出。
底层原理深度拆解
span 树的形状:Agent 到底该拆成几个 span
先把形状固定下来。一个用户回合(turn)对应一条 trace,根 span 是 invoke_agent,下面是模型调用、工具调用、检索步骤:
flowchart LR
  A["Agent App<br/>OTel SDK + GenAI 埋点"] -->|"OTLP/gRPC :4317"| B["OTel Collector<br/>Gateway 集群"]
  B --> C1["attributes + redaction<br/>PII 脱敏 / 丢密钥"]
  C1 --> C2["transform (OTTL)<br/>旧属性名归一化"]
  C2 --> C3["tail_sampling<br/>错误与慢请求 100% 保留"]
  C3 --> D1[("Tempo / OpenObserve<br/>traces")]
  C3 --> D2[("Prometheus<br/>gen_ai.* metrics")]
  C3 --> D3[("Langfuse / Phoenix<br/>会话视图 + 评估")]
上图是本文要搭的整体数据流:应用侧只负责产生符合约定的遥测,脱敏、归一化、采样、路由全部收敛到 Collector。这是 OpenTelemetry "采集与存储解耦"的核心价值——你换后端、换采样策略、加脱敏规则,都不用改业务代码。
span 树本身则是这样的层次:
invoke_agent support-agent (INTERNAL)            ← 一次用户回合
├── invoke_workflow ticket-triage (INTERNAL)     ← 可选的确定性流程
│   └── chat gpt-4o (CLIENT)                     ← 模型决策
├── execute_tool query_order (INTERNAL)          ← 工具执行
│   └── tools/call query_order (CLIENT)          ← MCP 客户端
│       └── tools/call query_order (SERVER)      ← MCP 服务端,跨进程续接
├── embeddings text-embedding-3-large (CLIENT)
├── retrieval knowledge_base (CLIENT)            ← v1.40 新增
└── chat gpt-4o-mini (CLIENT)                    ← 生成最终回答
命名规范要背下来,因为它直接决定瀑布图能不能一眼读懂:
- 模型调用:
{gen_ai.operation.name} {gen_ai.request.model}→chat gpt-4o - 工具执行:
execute_tool {gen_ai.tool.name}→execute_tool query_order(v1.41 起必须带工具名) invoke_agent的 span kind:调用远程 Agent 服务用CLIENT,LangGraph 这类进程内本地框架执行用INTERNAL(v1.41 起明确拆分)create_agent:面向 Assistants API、Bedrock Agents 这类远程 Agent 服务- MCP:
tools/call {tool},kind 为CLIENT(客户端侧)/SERVER(服务端侧)
属性分类学:Required / Conditionally Required / Recommended / Opt-In
这是读任何一张约定表最快的抓手,也是本文后面所有配置选择的依据。
| 要求级别 | 默认是否包含 | 能否配置追加 | 能否配置删除 | 含义 |
|---|---|---|---|---|
Required |
是 | 不适用 | 否 | 必须填充;消费方可用其存在性判断"这是一个 GenAI span" |
Conditionally Required |
条件成立时是 | 否 | 否 | 条件由约定明文规定,条件不成立则属性不存在 |
Recommended |
是 | 否 | 是 | 除非有基数、成本、隐私上的具体理由,否则应填 |
Opt-In |
否 | 是 | 是 | 需要显式开启;所有可能承载提示词或完成内容的属性都在这一档 |
两条推论非常实用:
- 因为
gen_ai.operation.name在每个 GenAI span 上都是Required,它的存在本身就是"这是一个 GenAI span"的可靠探测器。你可以直接用它写过滤规则,而不是去枚举 span 名。 Opt-In这一行,就是整套约定的隐私设计。内容默认不采集,不是"忘了做",是设计目标。
核心属性清单(chat 场景):
| 属性 | 类型 | 说明 |
|---|---|---|
gen_ai.operation.name |
string | chat / text_completion / generate_content / embeddings / execute_tool / invoke_agent / create_agent / invoke_workflow |
gen_ai.provider.name |
string | openai / anthropic / aws.bedrock / azure.ai.openai(取代已废弃的 gen_ai.system) |
gen_ai.request.model |
string | 请求的模型 |
gen_ai.response.model |
string | 实际服务的模型(可能是带日期快照,或微调后的具体版本) |
gen_ai.usage.input_tokens |
int | 输入 token 数,成本主驱动 |
gen_ai.usage.output_tokens |
int | 输出 token 数,成本主驱动 |
gen_ai.response.finish_reasons |
string[] | 数组,["stop"] / ["tool_calls"] / ["length"] |
gen_ai.response.id |
string | 厂商侧响应 ID,用于和厂商工单对齐 |
gen_ai.conversation.id |
string | 会话/多轮归组,抓 Agent 死循环的关键 |
gen_ai.request.temperature / top_p / max_tokens |
double/int | 影响输出语义而非仅性能,质量回归分析必用 |
error.type |
string | 限流、超时、内容策略拦截——GenAI 的"5xx" |
gen_ai.request.model 和 gen_ai.response.model 分开不是啰嗦:你请求 gpt-4o,实际可能落到 gpt-4o-2024-08-06;做质量对比时按 response.model 分组,才能发现厂商静默切换快照带来的漂移。同理 provider.name 与 request.model 分离,是因为同名模型可能来自 Azure 或官方直连,而 provider.name 决定后续哪些厂商专属属性适用。
v1.40 / v1.41 新增的两组属性值得单独记:缓存 token(如 gen_ai.usage.cache_read.input_tokens)和推理 token(gen_ai.usage.reasoning.output_tokens)。前者直接决定你的提示词缓存命中率是否真的省钱,后者是推理模型"思考成本"的唯一量化出口——没有这两个字段,你的成本报表会把缓存命中和思考过程全部算错。
内容捕获:为什么 prompt 必须做成事件,而不是属性
这是所有团队至少会错一次的地方。提示词与完成内容不是标准 span 属性,它们走独立的事件通道,通过 trace_id / span_id 关联回来。
理由有三条,都很工程:
- 属性必然被索引。大部分后端对 span 属性建倒排索引,整段 prompt 进去,索引体积和查询开销一起爆。事件则可以按存储策略单独丢弃。
- 属性必然被导出。你在应用里"临时关掉"很难,而事件可以在 Collector 层用一条规则丢掉,业务代码零改动。
- 隐私。内容里日常就会出现姓名、手机号、账号、内部业务逻辑。默认不采集,是最安全的默认值。
三个标准事件:
gen_ai.client.inference.operation.details(v1.37 引入):承载一次调用的完整输入输出,替代过去"一条消息一枚事件"的碎片化做法。gen_ai.evaluation.result:承载质量评估结果(gen_ai.evaluation.score.value/gen_ai.evaluation.score.label),让 LLM-as-judge 的分数和 trace 长在一起。gen_ai.client.operation.exception:异常事件。
同时约定也点明了一个语言层面的限制:结构化属性在 events/logs 上支持,但在某些语言的 span 上尚不支持复杂类型。所以规范给的做法是——span 上序列化成 JSON 字符串,同时在事件上记录结构化形态。
三个信号的分工:别把指标算成 trace
- Traces:单次请求的形状与因果。会被采样,所以不能用来算总量。
- Metrics:预聚合的数值序列,全量保真、代价低。约定定义了两件核心直方图
gen_ai.client.token.usage(按gen_ai.token.type分 input/output)和gen_ai.client.operation.duration,另有 Agent 调用时长、每次调用次数、工具执行时长、流式时序等。 - Events / Logs:大体积、敏感、结构不定的载荷。
一句话原则:任何需要"精确聚合"的数字放指标,任何需要"看清这一次"的证据放 span/事件。想用 trace 算月度 token 总量,等于用抽样数据算账单,必然对不上。
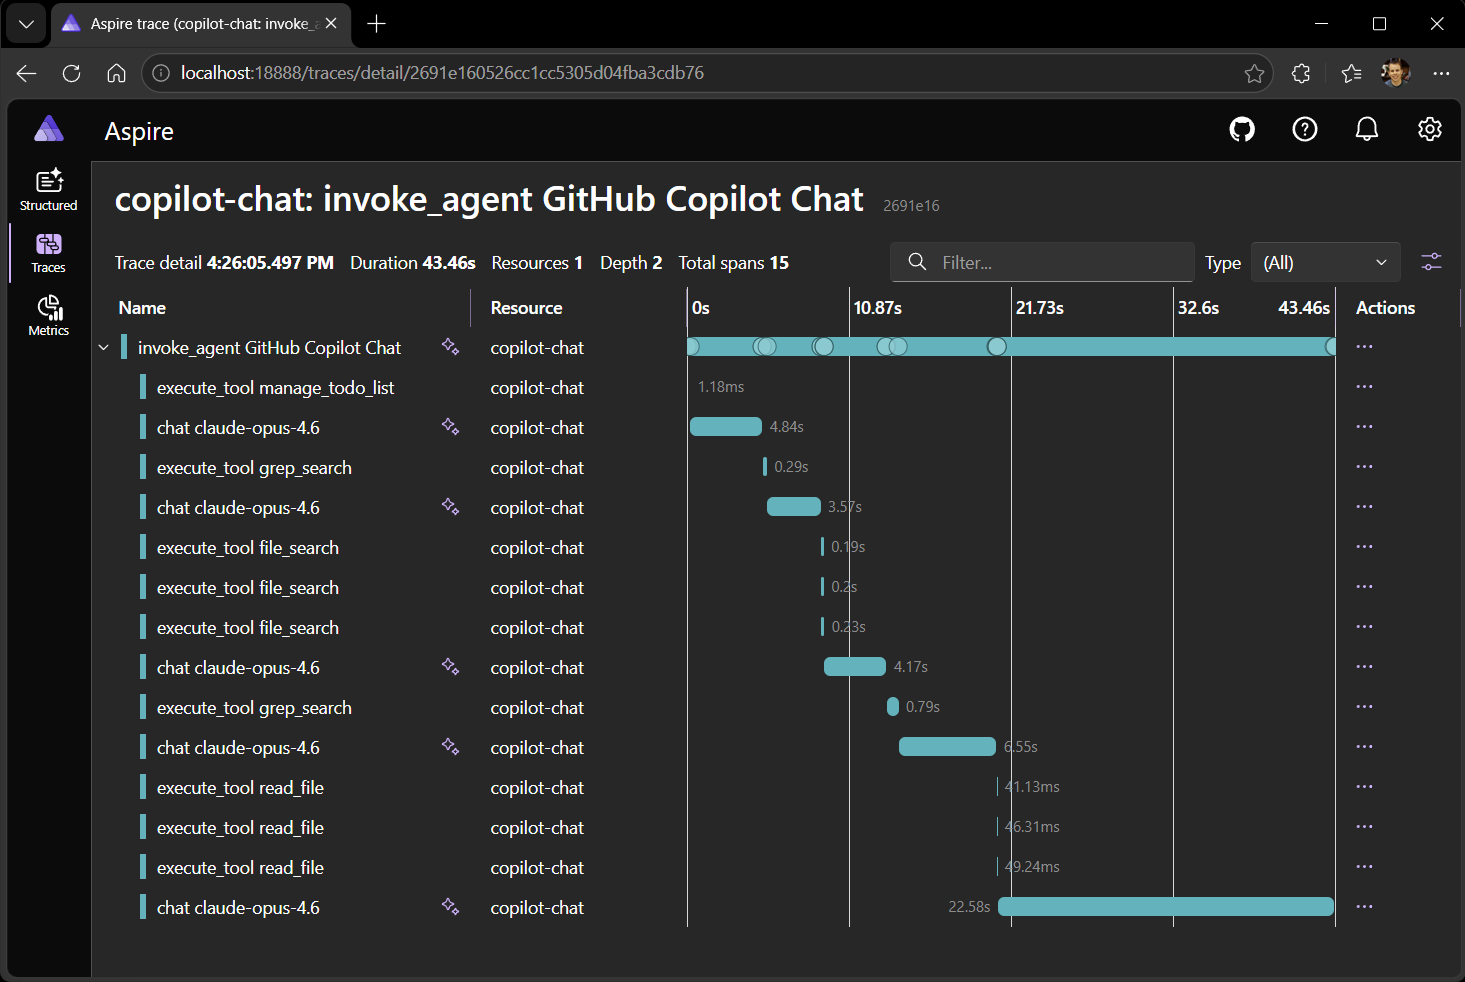
上图是标准 span 树在可视化后端的呈现:顶层 invoke_agent,其下每个 chat 是一次模型调用,每个 execute_tool 是一次工具调用。注意这种"读得懂"的瀑布图,前提就是 span 名遵循 {operation} {model} 与 execute_tool {tool} 规范——名字乱写,瀑布图立刻退化成需要逐个点开才能理解的列表。
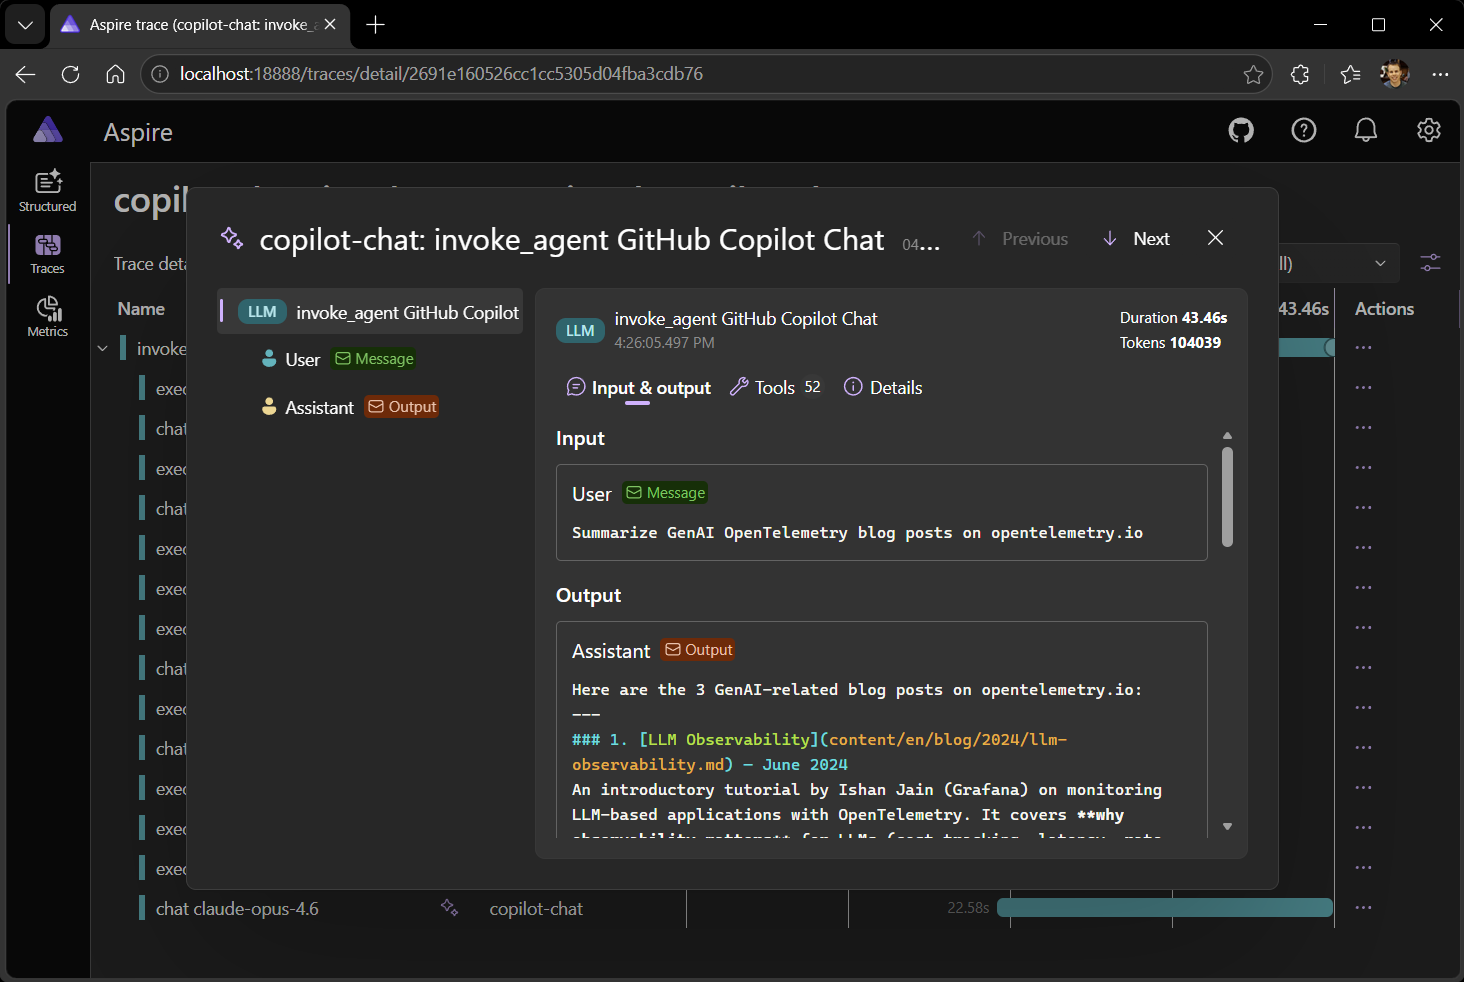
更进一步的后端会把 gen_ai.system_instructions、gen_ai.input.messages、gen_ai.output.messages 解析成聊天视图,直接看到系统提示词、用户消息、助手回答、工具参数与返回。这是"内容捕获"真正产生调试价值的地方。
手把手实战落地
下面六个示例构成一条完整链路:SDK 初始化 → 手工 chat 埋点 → RAG 检索埋点 → Agent 循环埋点 → Collector 脱敏与尾部采样 → 成本与质量聚合。环境假设:Python 3.11+、OpenTelemetry Python SDK 1.36+(该版本是 OTEL_SEMCONV_STABILITY_OPT_IN 的过渡基线)、一个可用的 OTLP 后端。
步骤 0:安装与目录
python -m venv .venv && source .venv/bin/activate
pip install "opentelemetry-sdk>=1.36" \
            "opentelemetry-exporter-otlp-proto-grpc>=1.36" \
            "opentelemetry-instrumentation-openai-v2" \
            openai
# 可选:本地看效果,不搭后端也能跑
docker run --rm -p 18888:18888 -p 4317:18889 -p 4318:18890 -d --name aspire \
  -e ASPIRE_DASHBOARD_UNSECURED_ALLOW_ANONYMOUS=true \
  mcr.microsoft.com/dotnet/aspire-dashboard:latest
坑先提一句:官方 GenAI instrumentation 里最成熟的是 OpenAI 这一支(包名 opentelemetry-instrumentation-openai-v2),Anthropic、Bedrock 等主要由社区库(如 OpenLLMetry)覆盖,LangGraph、CrewAI 的框架级埋点仍在推进中。这意味着你几乎一定要写手工埋点来补 Agent 编排层的 span,下面示例 2~4 就是这件事。
示例 1:初始化 TracerProvider,把采样策略一次定对
# otel_setup.py
import os
from opentelemetry import metrics, trace
from opentelemetry.sdk.resources import Resource
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.sdk.trace.export import BatchSpanProcessor
from opentelemetry.sdk.trace.sampling import ParentBased, TraceIdRatioBased
from opentelemetry.sdk.metrics import MeterProvider
from opentelemetry.sdk.metrics.export import PeriodicExportingMetricReader
from opentelemetry.exporter.otlp.proto.grpc.trace_exporter import OTLPSpanExporter
from opentelemetry.exporter.otlp.proto.grpc.metric_exporter import OTLPMetricExporter

OTLP_ENDPOINT = os.getenv("OTEL_EXPORTER_OTLP_ENDPOINT", "http://localhost:4317")


def setup_otel(service_name: str = "support-agent") -> TracerProvider:
    # 资源属性描述"谁在产生遥测",一次设置、处处携带
    resource = Resource.create({
        "service.name": service_name,
        "service.version": os.getenv("GIT_SHA", "dev"),          # 质量回归时按版本对齐
        "deployment.environment.name": os.getenv("ENV", "prod"),
        "gen_ai.application.name": "customer-support",            # 自定义维度,便于业务归因
    })

    # 头部采样:生产 10%,错误与慢请求由 Collector 的尾部采样兜底
    sampler = ParentBased(root=TraceIdRatioBased(
        float(os.getenv("OTEL_TRACES_SAMPLER_ARG", "0.1"))
    ))

    provider = TracerProvider(resource=resource, sampler=sampler)
    provider.add_span_processor(BatchSpanProcessor(
        OTLPSpanExporter(endpoint=OTLP_ENDPOINT, insecure=True),
        max_queue_size=4096,
        schedule_delay_millis=2000,
        max_export_batch_size=512,
        export_timeout_millis=30000,
    ))
    trace.set_tracer_provider(provider)

    # 指标全量上报,不采样——聚合数字必须精确
    meter_provider = MeterProvider(
        resource=resource,
        metric_readers=[PeriodicExportingMetricReader(
            OTLPMetricExporter(endpoint=OTLP_ENDPOINT, insecure=True),
            export_interval_millis=15000,
        )],
    )
    metrics.set_meter_provider(meter_provider)
    return provider
注意 ParentBased:它保证"父 span 未采样时子 span 也不采样",否则你会得到一堆没有根的孤儿 span。这是很多团队瀑布图残缺的直接原因。
示例 2:一次 chat span 的标准写法(含事件与异常)
# genai_chat.py
import time
from contextlib import contextmanager
from opentelemetry import trace
from opentelemetry.trace import Status, StatusCode

tracer = trace.get_tracer("ai.support.agent")

CONTENT_MAX = 800  # 内容截断上限,避免单事件体积失控


@contextmanager
def chat_span(model: str, provider: str = "openai", conversation_id: str | None = None, **params):
    """创建一个符合 GenAI 语义约定的 chat span。"""
    with tracer.start_as_current_span(f"chat {model}", kind=trace.SpanKind.CLIENT) as span:
        # Required + Recommended 属性
        span.set_attribute("gen_ai.operation.name", "chat")
        span.set_attribute("gen_ai.provider.name", provider)
        span.set_attribute("gen_ai.request.model", model)
        if conversation_id:
            span.set_attribute("gen_ai.conversation.id", conversation_id)
        for key, val in params.items():          # temperature / top_p / max_tokens
            if val is not None:
                span.set_attribute(f"gen_ai.request.{key}", val)
        try:
            yield span                            # 调用方在这里真正发请求
        except Exception as exc:
            # 异常必须落三处:异常事件、span 状态、error.type
            span.record_exception(exc)
            span.set_status(Status(StatusCode.ERROR, str(exc)))
            span.set_attribute("error.type", type(exc).__name__)
            raise


def call_llm(client, messages, model="gpt-4o-mini", conversation_id=None):
    with chat_span(model, conversation_id=conversation_id,
                   temperature=0.2, max_tokens=1024) as span:
        # 内容走事件而不是属性:可被 Collector 单独丢弃
        span.add_event("gen_ai.client.inference.operation.details", {
            "gen_ai.input.messages": str(messages)[:CONTENT_MAX],
        })
        t0 = time.perf_counter()
        resp = client.chat.completions.create(
            model=model, messages=messages, temperature=0.2, max_tokens=1024
        )
        span.set_attribute("gen_ai.client.operation.duration_ms",
                           round((time.perf_counter() - t0) * 1000, 1))
        # 响应侧属性:model 用 response.model,finish_reasons 是数组
        span.set_attribute("gen_ai.response.model", resp.model)
        span.set_attribute("gen_ai.response.id", resp.id)
        span.set_attribute("gen_ai.usage.input_tokens", resp.usage.prompt_tokens)
        span.set_attribute("gen_ai.usage.output_tokens", resp.usage.completion_tokens)
        span.set_attribute("gen_ai.response.finish_reasons",
                           [resp.choices[0].finish_reason or "stop"])
        span.add_event("gen_ai.client.inference.operation.details", {
            "gen_ai.output.messages": (resp.choices[0].message.content or "")[:CONTENT_MAX],
        })
        return resp.choices[0].message.content
如果你直接用 OpenAIInstrumentor().instrument(),上面这些属性会被自动填好,不需要手写。手工版的价值在于:推理服务走自建 vLLM、或走内部模型网关时,自动埋点覆盖不到,你只能手写——而属性名必须与约定一致,否则大盘查不出来。
示例 3:RAG 检索链路埋点(v1.40 的 retrieval span)
# genai_rag.py
from opentelemetry import trace

tracer = trace.get_tracer("ai.support.rag")


def retrieve(vector_db, embedder, query: str, top_k: int = 8):
    # 1) embedding 调用:operation.name=embeddings
    with tracer.start_as_current_span("embeddings text-embedding-3-large",
                                      kind=trace.SpanKind.CLIENT) as esp:
        esp.set_attribute("gen_ai.operation.name", "embeddings")
        esp.set_attribute("gen_ai.provider.name", "openai")
        esp.set_attribute("gen_ai.request.model", "text-embedding-3-large")
        emb = embedder.embed(query)
        esp.set_attribute("gen_ai.usage.input_tokens", emb.usage.prompt_tokens)
        esp.set_attribute("gen_ai.embeddings.dimension.count", len(emb.vector))

    # 2) 检索步骤:独立 span,并回填"召回了什么、分数多少"
    with tracer.start_as_current_span("retrieval knowledge_base",
                                      kind=trace.SpanKind.CLIENT) as rsp:
        rsp.set_attribute("gen_ai.operation.name", "retrieval")
        rsp.set_attribute("gen_ai.data_source.id", "kb-v3")
        rsp.set_attribute("db.vector.top_k", top_k)
        docs = vector_db.query(emb.vector, top_k=top_k)
        rsp.set_attribute("db.vector.results_count", len(docs))
        # 关键:把每条召回的相关性分数记下来,用于区分"检索差"还是"模型不听话"
        for i, d in enumerate(docs[:3]):
            rsp.set_attribute(f"app.retrieval.doc{i}.score", round(float(d.score), 3))
            rsp.set_attribute(f"app.retrieval.doc{i}.id", str(d.id))
        rsp.add_event("app.retrieval.summary", {
            "app.retrieval.avg_score": round(
                sum(d.score for d in docs) / max(len(docs), 1), 3),
        })
        return docs
这一步的工程价值最高。前面开篇那个案例里,"召回从 5 条掉到 2 条"这件事,只要 db.vector.results_count 和 app.retrieval.doc0.score 在 span 上,一条按时间排序的查询就能看出来;没有这两个字段,你要么加日志重发版,要么认栽。
示例 4:Agent 循环埋点(这里最容易写错)
# genai_agent.py
from opentelemetry import trace, context
from opentelemetry.trace import Status, StatusCode

tracer = trace.get_tracer("ai.support.agent")

MAX_STEPS = 8   # 硬上限,防死循环的第一道闸


def run_agent(client, task: str, tools: dict, conversation_id: str, tenant_id: str,
              max_steps: int = MAX_STEPS):
    # 根 span:进程内编排用 INTERNAL(远程 Agent 服务才用 CLIENT)
    with tracer.start_as_current_span("invoke_agent support-agent",
                                      kind=trace.SpanKind.INTERNAL) as span:
        span.set_attribute("gen_ai.operation.name", "invoke_agent")
        span.set_attribute("gen_ai.agent.name", "support-agent")
        span.set_attribute("gen_ai.agent.version", "2026.11.1")
        span.set_attribute("gen_ai.conversation.id", conversation_id)
        span.set_attribute("app.tenant.id", tenant_id)          # 成本归因关键
        span.set_attribute("app.agent.task_chars", len(task))

        messages = [{"role": "user", "content": task}]
        steps = tool_calls = 0
        try:
            while steps < max_steps:
                steps += 1
                resp = client.chat.completions.create(
                    model="gpt-4o", messages=messages, tools=list(tools.values())
                )
                msg = resp.choices[0].message
                messages.append(msg)

                if resp.choices[0].finish_reason != "tool_calls":
                    span.set_attribute("gen_ai.response.finish_reasons",
                                       [resp.choices[0].finish_reason or "stop"])
                    return msg.content

                for call in msg.tool_calls:                      # 一次可能多个工具调用
                    tool_calls += 1
                    # span 名必须带工具名:execute_tool {gen_ai.tool.name}
                    with tracer.start_as_current_span(
                        f"execute_tool {call.function.name}",
                        kind=trace.SpanKind.INTERNAL,
                    ) as tspan:
                        tspan.set_attribute("gen_ai.operation.name", "execute_tool")
                        tspan.set_attribute("gen_ai.tool.name", call.function.name)
                        tspan.set_attribute("gen_ai.tool.call.id", call.id)
                        try:
                            result = tools[call.function.name](**json.loads(call.function.arguments))
                            tspan.set_attribute("gen_ai.tool.call.result.size", len(str(result)))
                            messages.append({
                                "role": "tool",
                                "tool_call_id": call.id,
                                "content": str(result)[:2000],
                            })
                        except Exception as exc:
                            tspan.record_exception(exc)
                            tspan.set_status(Status(StatusCode.ERROR, str(exc)))
                            tspan.set_attribute("error.type", type(exc).__name__)
                            messages.append({"role": "tool", "tool_call_id": call.id,
                                             "content": f"ERROR: {exc}"})

            # 走到这里说明撞上上限:显式标记,别让它伪装成正常结束
            span.set_attribute("app.agent.hit_step_limit", True)
            span.set_status(Status(StatusCode.ERROR, "agent step limit exceeded"))
            return "抱歉,我暂时无法完成这个请求,已转人工。"
        finally:
            span.set_attribute("app.agent.steps", steps)
            span.set_attribute("app.agent.tool_calls", tool_calls)
三个细节值得停下来看:
app.agent.hit_step_limit这类"业务语义标记"是约定的延伸,不是约定本身。约定只管通用词汇,你的业务失败模式必须自己命名,但要统一前缀(这里用app.)并写进团队规范,否则下一个人会造出hitLimit/step_limit_hit两个不同名字。finally里落steps/tool_calls:即便异常抛出,这两个数字也要有——它们正是"空转"的直接证据。- 撞上限时必须把 span 标成 ERROR。默认成功状态会让你的"成功率"指标骗人。
示例 5:Collector 配置——脱敏、归一化、尾部采样一次到位
# otel-collector.yaml
receivers:
  otlp:
    protocols:
      grpc: { endpoint: 0.0.0.0:4317 }
      http: { endpoint: 0.0.0.0:4318 }

processors:
  # ① 兜底删密钥类属性
  attributes/scrub:
    actions:
      - { key: gen_ai.input.messages, action: delete }      # 未脱敏前一律不进后端
      - { key: http.request.header.authorization, action: delete }
      - { key: http.request.header.x-api-key, action: delete }

  # ② 正则遮值:内容已按策略采集时,就地掩码手机号/身份证/邮箱
  #    注意:redaction 处理器只作用于 traces,且只掩码字符串型属性
  redaction/pii:
    allow_all_keys: true
    blocked_values:
      - "1[3-9]\\d{9}"                                      # 手机号
      - "[\\w.+-]+@[\\w-]+\\.[\\w.]+"                       # 邮箱
      - "\\d{17}[\\dXx]"                                    # 身份证
    summary: info

  # ③ OTTL 归一化:把历史上写错的属性名统一成约定名
  transform/normalize:
    error_mode: ignore
    trace_statements:
      - context: span
        statements:
          - set(attributes["gen_ai.provider.name"], attributes["gen_ai.system"]) \
              where attributes["gen_ai.provider.name"] == nil and attributes["gen_ai.system"] != nil
          - delete_key(attributes, "gen_ai.system")
          - set(attributes["gen_ai.response.finish_reasons"], [attributes["gen_ai.response.finish_reason"]]) \
              where attributes["gen_ai.response.finish_reason"] != nil

  # ④ 尾部采样:错误、慢请求、超长会话全留,其余按 8%
  tail_sampling:
    decision_wait: 15s
    num_traces: 200000
    policies:
      - name: errors
        type: status_code
        status_code: { status_codes: [ERROR] }
      - name: slow
        type: latency
        latency: { threshold_ms: 15000 }
      - name: expensive-agent
        type: numeric_attribute
        numeric_attribute: { key: app.agent.tool_calls, min_value: 5 }
      - name: baseline
        type: probabilistic
        probabilistic: { sampling_percentage: 8 }

  batch: { send_batch_size: 1024, timeout: 5s }

exporters:
  otlp/tempo:
    endpoint: tempo:4317
    tls: { insecure: true }
  otlphttp/langfuse:
    endpoint: http://langfuse:3000/api/public/otel
    headers:
      Authorization: "Basic ${env:LANGFUSE_AUTH}"

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [attributes/scrub, redaction/pii, transform/normalize, tail_sampling, batch]
      exporters: [otlp/tempo, otlphttp/langfuse]
    metrics:
      receivers: [otlp]
      processors: [batch]
      exporters: [otlp/tempo]
这段配置里有几个真实分水岭:
redaction只管 traces,只管字符串值。数字型的敏感值、metrics/logs 里的敏感属性它都看不见,必须用attributes或transform补。transform用 OTTL 做"部分脱敏",redaction做"整体掩码"。要保留可读上下文(比如把138****1234留下),只能用transform。- 尾部采样必须放在 API 网关或 Agent 网关侧,因为只有那里能看到完整 trace 的结束状态。全链路的 Collector 都用尾部采样,会让每个节点都等 15 秒 buffer,延迟和内存双爆。
示例 6:让成本和质量真正可查询
到这一步遥测已经有了,最后一步是把它们变成能回答问题的查询。下面以 PromQL 与 TraceQL 为例(后端无关的写法思路,换成 OpenObserve / ClickHouse SQL 同理)。
# 每千次请求的估算成本(输入/输出分价,价格按实际合同替换)
sum by (gen_ai_request_model) (
  rate(gen_ai_client_token_usage_sum{gen_ai_token_type="input"}[5m])
) * 2.5 / 1e6
+
sum by (gen_ai_request_model) (
  rate(gen_ai_client_token_usage_sum{gen_ai_token_type="output"}[5m])
) * 10 / 1e6

# 按租户的 token 预算利用率(app.tenant.id 由业务侧注入)
sum by (app_tenant_id) (increase(gen_ai_client_token_usage_sum[1h]))
  / on(app_tenant_id) group_left
  kube_configmap_info{configmap="tenant-token-quota"}
# TraceQL:找出"检索召回退化 + 工具空转"的可疑 trace
{ span.gen_ai.conversation.id != nil
  && span.db.vector.results_count < 3
  && span.app.agent.tool_calls > 4 }
| select(span.gen_ai.request.model, span.db.vector.results_count, span.app.agent.tool_calls)
再把质量评估回写成事件,让"分数"和"trace"同源:
# judge.py —— 抽样 10%~20% 流量跑 LLM-as-judge,分数回写为事件
def record_evaluation(span, score: float, label: str, rubric_version="v3"):
    span.add_event("gen_ai.evaluation.result", {
        "gen_ai.evaluation.name": "answer_relevance",
        "gen_ai.evaluation.score.value": round(score, 3),
        "gen_ai.evaluation.score.label": label,       # 如 "relevant" / "partially"
        "app.evaluation.rubric_version": rubric_version,
    })
注意 judge 的评分提示词必须版本化(rubric_version)。否则当分数整体下移时,你永远要花半天确认:是模型变差了,还是评分提示词被谁改了。
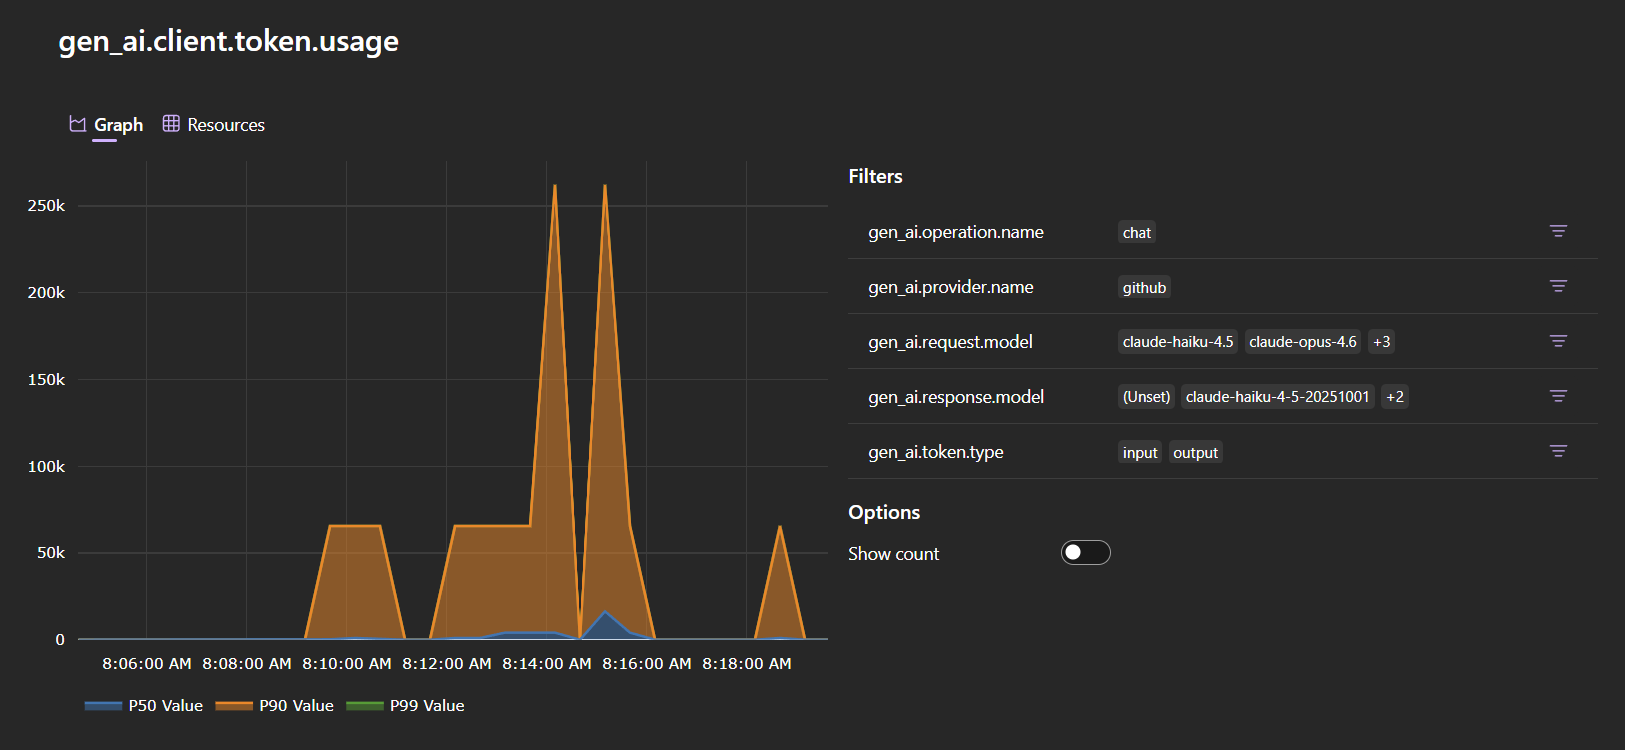
面板上真正要盯的就两类:gen_ai.client.operation.duration 按 (gen_ai.provider.name, gen_ai.request.model) 分组的 P95;gen_ai.client.token.usage 按 gen_ai.token.type 拆开的输入/输出增长。前者回答"慢在哪",后者回答"钱花在哪",且这两个数字不随口径变化。
关键细节与踩坑指南
下面每一条都来自"上线后才发现"的真实类型,附错误写法与正确写法。
坑 1:属性名版本漂移,大盘静默归零
gen_ai.system 在 v1.37 被 gen_ai.provider.name 取代。很多老 instrumentation 两个都发,很多新写的只发新的。如果你的面板查旧名,SDK 一升级,曲线归零——而面板归零不会报错,这是最危险的一类故障。
| 常见错误 | 正确做法 |
|---|---|
依赖默认行为,跟着 pip install -U 走 |
在依赖清单里显式 pin instrumentation 与 semconv 相关版本;每次升级当"一次埋点迁移"处理,而不是补丁更新 |
| 面板里混用新旧属性名 | 用 Collector transform 做一次归一化(示例 5 的 ③),让后端只见一种 schema |
用 gen_ai.response.finish_reason(单数) |
约定是 gen_ai.response.finish_reasons,数组 |
| 忽略过渡开关 | v1.36 是过渡基线,OTEL_SEMCONV_STABILITY_OPT_IN=gen_ai_latest_experimental 才会切到最新格式,要显式设定 |
另外别指望 Schema URL 自动帮你迁移:GenAI 仓库的 README 里 Schema URL 仍是 TODO,model/manifest.yaml 声明的 https://opentelemetry.io/schemas/gen-ai-dev/1.42.0-dev 目前没有实际文件可访问。现阶段迁移只能手工做。
坑 2:把 prompt 塞进属性,索引和钱包一起炸
❌ span.set_attribute("gen_ai.prompt", full_prompt)          # 数 KB,永久索引
✅ span.add_event("gen_ai.client.inference.operation.details", {...})   # 可被 Collector 丢弃
✅ span.set_attribute("app.prompt.chars", len(full_prompt))  # 属性里只留量级
把"长度"记进属性、把"内容"记进事件,是这个模式的通用解法:既能做"prompt 是否异常膨胀"的用量分析,又不让敏感内容进索引。
坑 3:根 span 建晚了,BatchSpanProcessor 把 trace 打散
BatchSpanProcessor 会缓冲子 span 等待批次。如果你的根 span 在请求末尾才创建或才结束,聚合与富化会静默失败,表现为"每次请求都只有零星几个 span"。根 span 必须在请求生命周期最开头创建,并确保异步任务里 context 正确传递(contextvars / context.attach)。
坑 4:采样偏差吃掉长尾故障
生产常设 10% 头部采样,但恰恰是"偶发的 1/200 空转"和"极慢的上下文溢出"会被采掉。正确姿势是头部 + 尾部双层:
- 头部:10%~30%,控制流量成本(这是行业常见的量级);
- 尾部:错误 100%、超阈值延迟 100%、
app.agent.tool_calls > 5100%,其余降到 5%~10%。
gen_ai.conversation.id 在这里是救命字段——没有它,多轮对话和 Agent 循环会显示成一堆互不相关的孤立 span,你根本看不出"同一个用户被拖了 40 秒"。
坑 5:MCP 工具调用出现两个重复 span
MCP 约定明确处理了这层重叠:如果 MCP instrumentation 能可靠判断外层 GenAI instrumentation 已经在追踪工具执行,它不应再建一个独立 span,而应该在已有 span 上补充 MCP 专属属性(mcp.method.name、mcp.session.id、mcp.protocol.version、jsonrpc.request.id)。所以当你看到每个工具调用都出现两次时,八成是两层 instrumentation 同时开启且没走互认逻辑——去查配置开关,别急着写去重代码。
顺带记:MCP 的 stdio 传输在 network.transport 里映射为 pipe,HTTP 传输是 tcp(或 quic)配 network.protocol.name=http。这两个值写错,按传输方式拆的延迟分析就废了。
坑 6:流式响应统计不到 token
流式(SSE)场景下,很多实现拿到首个 chunk 就返回,usage 是在最后一个 chunk 才出现(或需要显式开启 stream_options={"include_usage": true})。漏了这一步,gen_ai.usage.output_tokens 全是 0,成本报表直接失真。v1.41 专门补了流式时序指标(首 token 延迟等),这类"用户感知的慢"只能靠它测——用总时长代理首 token 延迟是常见的错误口径。
坑 7:把 model 写成资源属性
"我们服务只用一种模型"是暂时的。第一次加 fallback 模型或做 A/B 对比,这个假设就崩了,而资源属性是进程级的,改起来要重启。gen_ai.* 里的任何属性都不是资源属性。
坑 8:PII 处理放在查询时而非摄取时
在摄取时脱敏和在查询时脱敏是两件事。前者数据落地就是安全的,后者一旦后端被读、被导出、被同步到数据仓库,泄露就发生了。默认关闭内容捕获 → 需要时经 Collector 脱敏 → 后端按角色做 RBAC,三层缺一不可。
坑 9:把"成功"定义成 finish_reason == "stop"
用户要的答案可能触发了 tool_calls 就结束了,也可能 length 截断,更可能是 stop 但答案是幻觉。所以"成功率"必须由三层合成:传输层(无异常)、编排层(app.agent.hit_step_limit=false)、质量层(gen_ai.evaluation.score.value 高于阈值)。少一层,你的成功率指标就会在故障期保持优雅的 99.9%。
生产环境最佳实践
配置规范(可直接抄)
| 项目 | 建议值 | 理由 |
|---|---|---|
service.name / service.version |
必填,version 用 git sha | 质量回归与发布对齐的唯一锚点 |
deployment.environment.name |
prod / staging / dev |
避免压测流量污染生产大盘 |
| 头部采样率 | prod 10%,staging 100% | 控成本且保留调试能力 |
| 尾部采样 | 错误/慢/高工具调用数 100%,其余 5%~10% | 长尾故障必留 |
| 内容捕获 | 默认关;按租户/环境白名单开 | 隐私与成本的默认最优解 |
| 内容截断 | 每段 500~1000 字符 | 控制事件体积 |
| 指标导出间隔 | 15s | 与常见 Prometheus 抓取节奏对齐 |
| span 事件上限 | 单 span ≤ 20 条 | 防某段业务循环打爆内存 |
成本归因:把账单切成可决策的块
归因维度至少三层:app.tenant.id(谁用)、gen_ai.request.model(用哪个)、app.agent.name / app.feature(哪个功能)。写法上有两个选择:业务侧穷举注入(简单但易漏),或用 SpanProcessor 从 baggage 统一下刷:
from opentelemetry.sdk.trace import SpanProcessor
from opentelemetry import context

class ContextEnricher(SpanProcessor):
    """把请求级上下文(租户、会话、灰度标识)统一下刷到所有 span。"""
    KEYS = ["app.tenant.id", "gen_ai.conversation.id", "app.canary"]

    def on_start(self, span, parent_context=None):
        for key in self.KEYS:
            value = context.get_value(key) if parent_context is None else None
            if value is not None:
                span.set_attribute(key, value)
这个模式解决了一个具体痛点:gen_ai.conversation.id 这类字段不会自动下传到子 span,逐处手写必然漏。用一个 processor 在 on_start 补齐,才是可维护的做法。
高可用与降级
遥测链路自己也要有不拖垮业务的觉悟:
- exporter 全部走批量 + 队列上限,队列满了丢遥测不丢请求;
- Collector 分两层:Agent 侧 DaemonSet(就近、便宜)+ Gateway(做尾部采样与多后端路由);
- 后端不可用时,Collector 用
memory_limiter+ 落盘队列撑住,而不是让 SDK 同步重试; - 埋点开销实测口径:每次 LLM 调用 < 1ms(社区普遍报告的量级),相对于 100ms~30s 的模型延迟基本是噪声;真正的成本大头是遥测存储体积,用采样和内容截断控制。
容量估算(可复现的口径)
给你一个自己动手能算的模型,别信抽象的"省 90%":
单 trace 存储 ≈ span 数 × (基础属性 ~1.5KB + 内容事件字节 × 内容开启比例)
采样后日增 ≈ 日活请求 × 会话均 trace 数 × 单 trace 体积 × 采样率
按一个中等规模客服 Agent 估:每条 trace 约 9 个 span(1 根 + 5 次 chat + 3 次 tool),内容关时单 trace 约 14KB;若把 2KB×2 的提示词与完成内容塞进属性,单 trace 膨胀到 22KB 以上,且这部分会进索引,检索开销的放大倍数远高于体积放大的 1.6 倍。把内容移出属性 + 采样 20% 之后,日增体积通常会下降一个量级——这个数字你自己跑一周就能验证,不必采信任何二手结论。
横向对比与选型建议
| 方案 | 优势 | 代价 | 适合谁 |
|---|---|---|---|
| 纯应用日志 + grep | 零成本起步 | 无法表达调用树、无法做跨层归因、排障以天计 | 单次调用、无 Agent 编排的原型 |
| 自研 trace 结构(自己建表) | 完全贴合业务 | 属性名无法与生态互通、换后端要重写、埋点易漂移 | 有强平台团队且不打算用第三方 |
| OTel GenAI 语义约定 | 厂商中立、后端可换、生态增长最快(OpenAI instrumentation 最成熟) | 词汇表仍在 Development,需自己管迁移 | 绝大多数生产 LLM / Agent 应用(推荐) |
| OpenInference 语义约定 | Agent 与工具调用关联更细(tool_call_result.*、检索/重排有一等公民 span) |
生态偏 Arize/Phoenix;与 GenAI 约定并存时需做归一 | 重度 RAG、需要精确定位"上下文错了"的场景 |
| 商用一体化平台(Datadog LLM Obs. 等) | 与既有 APM 同屏,运维心智统一 | 按 span 计费、数据出境/合规需评估 | 已在用同厂 APM 的中大型组织 |
选型决策路径,按顺序问自己四个问题:
- 你的模型调用能自动埋点吗? 走 OpenAI/Anthropic 兼容接口 → 上自动 instrumentation,30 分钟见效;走自建 vLLM 或内部网关 → 直接写手工埋点,但要严格用约定属性名。
- 你有 Agent 编排吗? 有 → 必须自己补
invoke_agent/execute_tool/retrieval三层手工 span,因为框架级埋点还不齐。 - 内容要不要落库? 要 → 先建好 Collector 脱敏管线再接内容,不要"先全采,以后再脱敏"。
- 后端选谁? 已有 APM → 优先复用(少一个系统);需要 LLM 语义视图与人工标注 → 加 Langfuse / Phoenix 作为第二落点(OTLP 双写,前端按需切)。
一条容易被忽略的建议:GenAI 约定与 OpenInference 不是二选一。两者都跑在 OTel 之上,实践中常见做法是用 GenAI 约定做主干(跨团队、跨服务统一),在检索与重排这两层额外附加 OpenInference 的细粒度属性,由 Collector 统一归一。
性能实测与效果验证
先明确口径,避免拿不同量纲的数字对比:下面分两类,社区公开量级与你能自己复现的计算。
| 指标 | 数值 | 口径说明 |
|---|---|---|
| 单次模型调用埋点开销 | < 1ms | 社区普遍报告量级;相对 100ms~30s 的模型延迟可忽略 |
| span 数量膨胀 | 每回合 1 个 → 8~12 个 | 取决 Agent 步数(5 次 chat + 3 次 tool + 1 根 + 检索 2) |
| 内容进属性 vs 进事件 | 单 trace 体积约 22KB → 14KB | 按 2KB×2 内容、9 span 估算;索引开销放大更显著 |
| 采样后日增体积 | 下降约 80%~90% | 头部 10% + 尾部错误全留的典型组合 |
| 故障定位耗时 | 手工加日志 2 |
场景:RAG 召回退化 + 工具空转复合故障 |
最后一行是本文最关心的收益。用开篇那个案例复盘:有了 db.vector.results_count、app.retrieval.doc0.score、app.agent.tool_calls、gen_ai.conversation.id 四个字段,排查路径从"猜三层"变成一条固定流水线:
按
gen_ai.conversation.id定位错误会话的 trace → 看retrievalspan 的results_count与首条分数是否低于基线 → 再看根 span 的app.agent.tool_calls是否异常偏高 → 打开gen_ai.input.messages事件确认提示词里拼进去的上下文是否缺失 → 得出结论"检索无内容"还是"模型未遵从上下文"。
这套流水线是可以写进值班手册的,这也是标准化的真正价值:它让排障从"资深工程师的经验"变成"任何人都能执行的步骤"。
验证自己链路是否合格,用这几条 checklist(前四条任一不过,说明埋点没接好):
- 随便取一条 trace,能一眼看出 span 树有
invoke_agent→chat/execute_tool三层; - 每个 GenAI span 都有
gen_ai.operation.name(这是Required,缺了说明不是合规埋点); - 所有
chatspan 都带usage.input_tokens/usage.output_tokens,加起来与厂商账单数量级吻合; - 按
gen_ai.request.model分组能算出 P95 延迟,按app.tenant.id能算出用量; - 关掉内容捕获后,检查后端确认没有任何提示词文本残留。
总结与未来展望
回到一句话:Agent 的可观测性不是"多打日志",而是"把编排结构表达成标准 span 树"。你需要的核心能力只有三件——属性名严格对齐 gen_ai.* 约定、内容走事件而非属性、采样与脱敏收敛到 Collector。做到这三点,换后端、加模型、上多 Agent 都不用重写埋点。
关于未来,两件事值得提前准备:
第一,GenAI 约定正在从"模型调用"往"多智能体协作"走。Agent 团队、任务、记忆、产物追踪都在讨论中,语义稳定后你现在的 invoke_agent 树会自然长出更细的层次。现在打好 gen_ai.conversation.id + 业务前缀属性的基础,届时迁移成本最低。
第二,MCP 与 Agent 框架的埋点会从"手工补"变成"开箱有",但自动埋点永远无法覆盖你的业务失败模式(空转、检索退化、权限误判)。这些必须你自己命名、自己建指标——这部分投入不会因为生态成熟而消失,只会从"补 span"变成"定义语义"。
延伸阅读
- OpenTelemetry GenAI 语义约定仓库(属性、指标、事件、MCP 与 Agent 规范的唯一权威源)
- Inside the LLM Call: GenAI Observability with OpenTelemetry(官方实操:从 Copilot 导出遥测到 Aspire Dashboard 查看 span 树与指标)
- OpenTelemetry GenAI Semantic Conventions Implementation Guide(逐条转录属性表与要求级别,含迁移与隐私设计章节)
- How OpenTelemetry Traces LLM Calls, Agent Reasoning, and MCP Tools(六层规范演进与 v1.37→v1.41 变更脉络)
标签:OpenTelemetry、GenAI 语义约定、AI Agent 可观测性、LLM 工程化、分布式追踪、MCP 协议、成本归因、AI 工程化