语音 Agent 一被抢话就卡死?全双工打断与 800ms 延迟预算工程

用户插话那一刻,考验的不是模型,而是你能不能把 TTS、LLM、ASR 三条流在 150ms 内一起掐断、并把"它说到哪了"精确记账。
开篇:一通被"抢话"毁掉的客服电话
去年我们给一家保险公司上线电话客服 Agent,功能测试全绿:意图识别 94%、工单准确率 91%、平均响应 1.1 秒。上线第三天,业务方给了一个致命反馈:"它不听人说话。"
复盘一通真实录音就很清楚。坐席端(其实是 AI)正在说:"您的保单生效日期是 2026 年 3 月 15 日,保障范围包含……",用户在 1.8 秒处插话:"等一下,我問的是理赔。" 系统检测到语音活动,于是把上一段话截断了——但截断点在音频缓冲区的末尾,用户听到的是"保障范围包含住"这半句,而 TTS 内部已经合成到"住院医疗与门诊手术,年度限额……"。更糟的是,对话历史里完整记录了 LLM 生成的整段文本,模型"以为"用户已经听过后面的内容,下一轮回答直接跳过关键信息。用户重复问了三次,最后挂断。
这一通电话暴露的不是模型能力问题,而是三件纯工程问题:延迟预算没有分段管控、打断动作没有全链路传播、被打断后的上下文没有对账。这三个问题在 2026 年的语音 Agent 生产环境里,比"选哪个模型"重要一个量级。
本文只讲一件事:如何把实时语音 Agent 做到"能被打断、被打断后不崩"。你会拿到一套可以直接落地的延迟预算模型、一个三路信号融合的 barge-in 检测器、一套可取消的流式管线实现,以及一份踩过坑之后沉淀的生产配置模板。
技术背景与核心概念扫盲
三种架构,一个共同敌人
2026 年做语音 Agent,架构选项收敛为三类:
级联管线(Cascaded Pipeline):VAD → Streaming ASR → Turn Detection → LLM → Streaming TTS,五个独立组件用流式帧串起来。Vapi、Retell、Bland.ai 以及绝大多数 LiveKit / Pipecat 项目都是这一套。优点是每个环节可替换、可单独观测、可换自研模型;缺点是延迟逐级累加,打断时要协调五个组件的取消与状态恢复。
原生语音到语音(Native Speech-to-Speech, S2S):音频进、音频出,中间没有显式文本。OpenAI 的 gpt-realtime 系列、Google Gemini Live、Amazon Nova 2 Sonic 属于这一类;开源侧 Moshi、Qwen2.5-Omni、GLM-4-Voice 也在追。
半级联(Half-Cascade):模型内部仍走文本推理,但对外暴露单一音频接口,把 STT 终结等待和 TTS 启动延迟藏进模型内部。
一个必须知道的事实:开源原生 S2S 模型到 2026 年仍不适合做实时生产 Agent。有公开实测显示,Qwen2.5-Omni-7B 走 Thinker-Talker 架构时,Talker 部分的实时因子(Real-Time Factor, RTF)约 1.93×,也就是生成 1 秒音频要花约 2 秒;句子级流式下首音延迟(Time-To-First-Audio, TTFA)仍高达 13.2 秒。同时,绝大多数开源 S2S 模型不支持函数调用(Function Calling),而企业 Agent 的业务能力恰恰全押在工具调用上。这就是为什么 2026 年生产系统里级联管线仍占大头。
五个必须先定义清楚的概念
| 概念 | 英文 | 一句话定义 | 典型量级 |
|---|---|---|---|
| 语音活动检测 | VAD (Voice Activity Detection) | 判断"这一帧音频里有没有人声" | 决策延迟 ~30ms |
| 端点判定 | Endpointing | 判断"这句话是不是说完了"(纯声学) | 静音阈值 300–800ms |
| 轮次判定 | Turn Detection | 综合语义+声学判断"该不该我接话" | 模型推理 10–50ms |
| 打断 | Barge-in | 用户在 Agent 说话时插话,Agent 立即停 | 响应窗口 <150ms |
| 首音延迟 | TTFA / FTL | 用户说完 → 用户听到第一个音节 | 目标 <800ms |
注意 VAD 和 Turn Detection 的区别,这是新手最大的认知坑:VAD 只回答"现在有没有声音",Turn Detection 回答"这段声音是不是一个完整意图"。用户说"我想订一张……(停顿 600ms)……明天去上海的票",纯 VAD 会在 600ms 静音处判定说完,LLM 抢话,这就是"AI 老打断我"的根源。
人类基准与可用阈值
人类对话的轮次交替间隙平均约 200ms(有研究测得 208ms 左右)。工程上公认的经验阈值为:
- <800ms:听起来像"数字人但很顺畅",可用;
- 800ms–1.2s:明显迟滞,用户开始怀疑卡顿;
- >1.2s:用户会主动开口"喂?在吗?",形成二次打断,体验崩塌。
有观测研究对 9 名语音助手用户实测,平均响应延迟达到 1366ms——这基本就是"用户开始抢话"的区间。所以本文把 800ms 当作硬预算线,把 600ms 当作优化目标。
底层原理深度拆解
一、延迟预算:930ms 是串行上限,600ms 是流水线极限
先把钱花在哪看清楚。串行执行时:
T_serial = T_VAD + T_ASR_final + T_turn + T_LLM_ttft + T_TTS_ttfb
         = 30  +  150       +  200   +  400        +  150
         = 930ms
这 930ms 还没算网络。一旦改成流水线(Pipelining)——用户还在说话时 ASR 就在转录、LLM 出第一个句子时 TTS 就开始合成——关键路径变成:
T_pipeline = T_VAD + T_ASR_final + T_turn + T_LLM_first_sentence + T_TTS_ttfb
因为 LLM 的"出第一句"远快于"出完整回答",T_LLM_first_sentence 通常只有 300ms 左右,于是落到 ~600ms,加上 50–200ms 网络 RTT,跨网用户体验 700–800ms。
这张图把五段预算摆在一起看,比任何文字都直观:
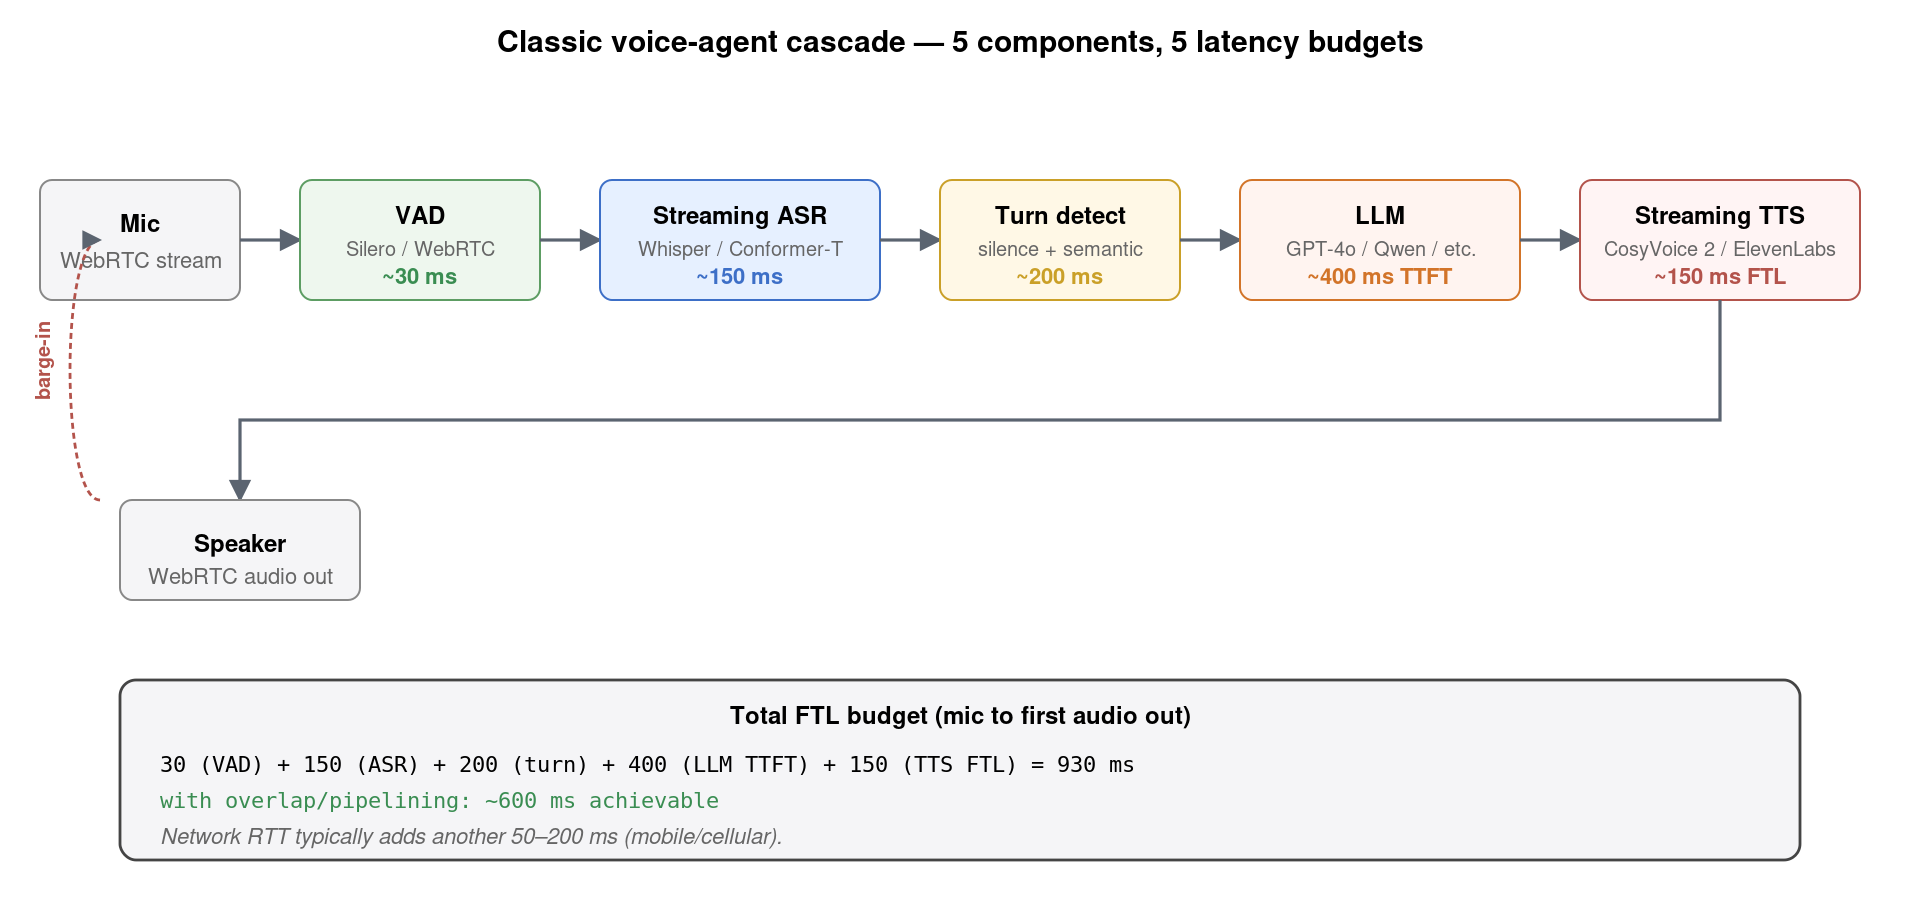
图 1:经典五件套架构及各段延迟预算(VAD 30ms + ASR 150ms + Turn Detection 200ms + LLM TTFT 400ms + TTS FTL 150ms = 930ms 串行,流水线化后约 600ms)。图源:yudonglee.me
几个真实测得的基线值,建议你直接拿来做容量规划(均来自公开可复现测试):
- 流式 ASR(Deepgram Nova-3,WebSocket):音频到最终转录 P50 为 337–509ms,最优 184ms;
- 流式 LLM(vLLM 0.8.x + Qwen2.5-7B-Instruct,单卡 A10G):TTFT P50 337ms;
- 流式 TTS(ElevenLabs eleven_turbo_v2_5):TTFB P50 219–236ms,RTF 0.05–0.10×;
- 整条管线(Deepgram + vLLM + ElevenLabs):P50 TTFA 947ms,最优 729ms。
也就是说:不做优化,你天然就在 950ms 附近,刚好越过可用线。想进 600ms,只有三条路——砍 turn detection 的等待、砍 LLM 首句、砍传输跳数。
二、Barge-in 的本质:三路信号 + 一个状态机
很多人把 barge-in 理解成"检测到声音就停"。这是所有 bug 的起点。工业级实现至少要融合三路信号:
- 能量门限(Energy Threshold):帧级 RMS 转 dBFS,低于门限直接否掉,成本近乎为零;
- 语音分类器(Voice Classifier):Silero VAD 这类轻量模型,判断"是不是人声",滤掉键盘、敲击、音乐;
- 最短持续时长(Min-Duration Guard):连续 N 帧满足才确认,滤掉咳嗽、呼吸、单字噪声。
仅这三路还不够,工程上还要叠两个约束:AEC 保护窗(Agent 刚开始播报的 100–150ms 内,扬声器余音可能被麦克风拾取,直接判打断会造成"自己打断自己")和后向通道(Backchannel)识别。用户说"嗯""对""好",在声学上与打断几乎无法区分,但语义上它希望 Agent 继续。2026 年主流框架的做法是引入语义判定:LiveKit 的 turn detector + 自适应打断处理会把模糊的 VAD 触发判为后向通道而非切断。一个可用的启发式:打断音频时长 <300ms 且 ASR 只给出一个语气词/单字 → 当后向通道处理,不切断。
确认打断之后,要做的事远不止"停音频":
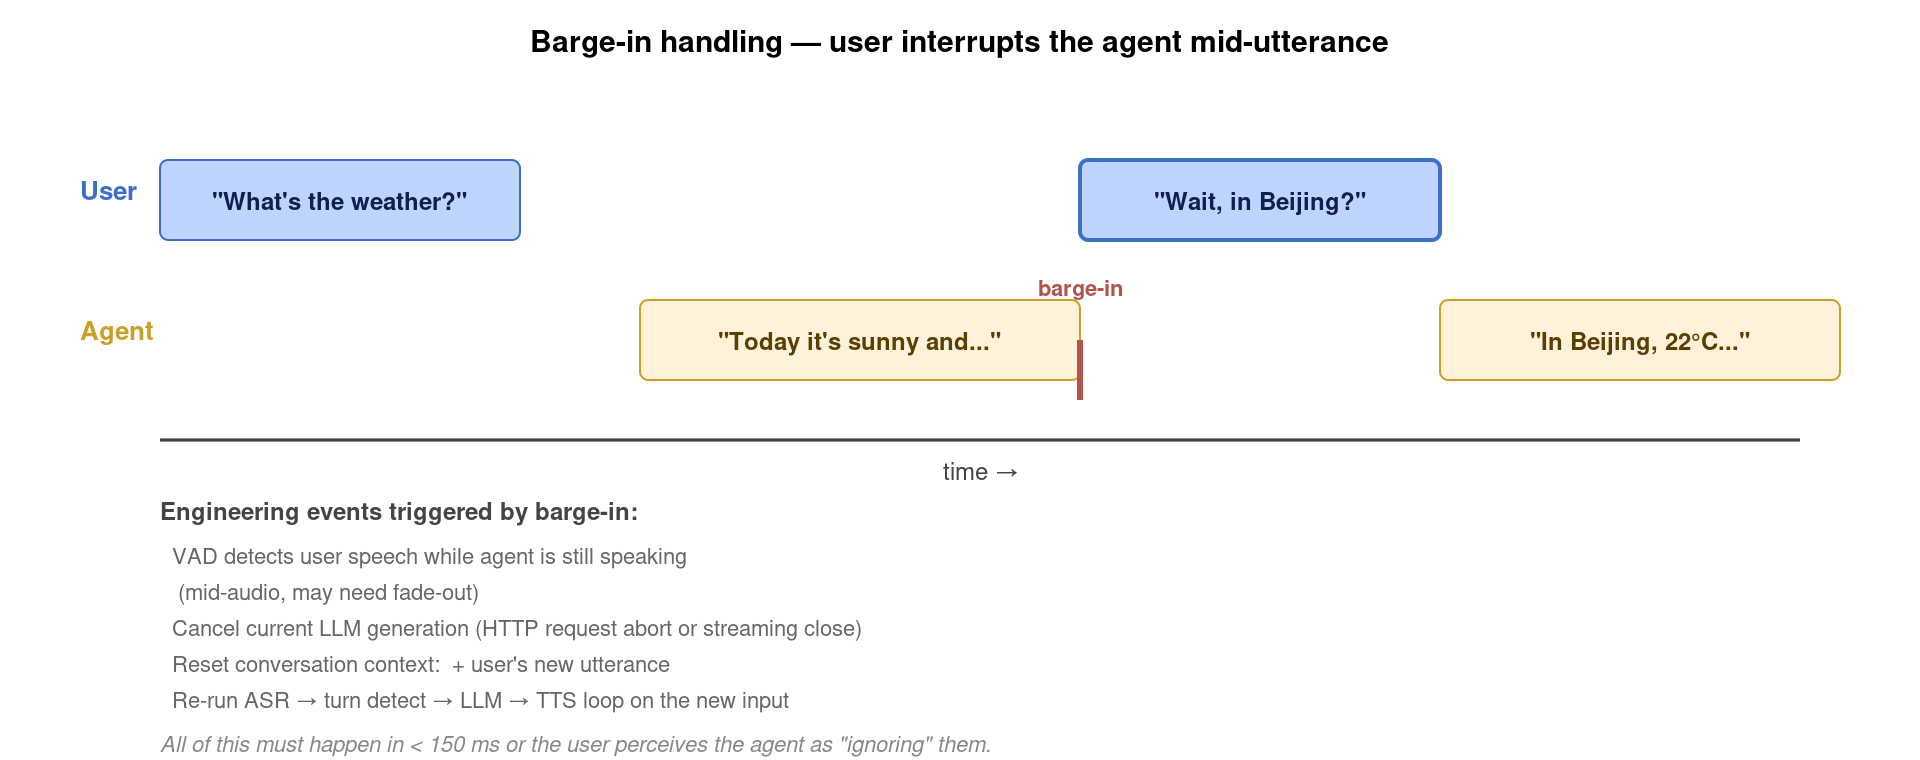
图 2:一次 barge-in 的完整动作序列——VAD 检测用户开口 → 取消 TTS 流 → 取消 LLM 流 → 重置/修复上下文 → 重跑 ASR→Turn→LLM→TTS。全部动作须在 150ms 内完成。图源:yudonglee.me
关键在第 4 步:上下文修复。级联架构里最容易漏的就是这一环。用户实际听到的只有前半句,但 LLM 生成的是完整段落;如果原样把整段 append 进 history,模型会以为信息已传达。正确做法是记录"已播出文本(text_spoken)"与"未播出文本(text_remaining)",history 里只写已播部分,未播部分要么丢弃、要么在下一轮以"我刚说到 X"的方式自然续上。
三、为什么级联架构的打断这么难
因为状态散落在五个进程里。打断瞬间你需要同时处理:
| 层 | 状态 | 取消动作 | 典型失败 |
|---|---|---|---|
| 传输层(WebRTC/SFU) | 抖动缓冲里还有 20–80ms 音频 | 清空播放队列 | 已进 jitter buffer 的音频继续播出,用户听到"余音" |
| TTS | 已合成未播出的音频块 + 内部韵律状态 | 断开或发 Interrupt | 无法得知"播到哪个字" |
| LLM | SSE 流已生成后续 token | abort HTTP 流 | 取消不彻底,token 继续流入缓冲区 |
| 会话状态 | history 里的文本 | 对账后重写 | 孤儿词泄漏到下一轮 |
| ASR | 正在转录用户新语音 | 保留 | 新语音被旧文本污染 |
这里有个真实存在的开源 bug 可以佐证"文本对账"有多难:Pipecat 的 issue #4996 记录了打断帧超过已释放文本帧的竞态——某个轮次提交的文本是 "The pool opens",而用户实际听到的是 "The pool opens at six.",剩下的 "at six." 因为帧竞态没被计入已播部分,泄漏进下一轮助手消息,变成 "at six. We close at nine."。用户在电话里听到的是一句逻辑断裂的鬼话。
反过来看,把对账做在服务端的方案就干净得多。Deepgram Flux TTS 的 /v2/speak 在收到带 playback_offset 的 Interrupt 后,返回 SpeechInterrupted 事件,其中包含 audio_played_ms、text_spoken、text_remaining 三个字段——"用户到底听到了哪几个字"由 API 直接告诉你,客户端不用自己重建。这是一个值得记住的设计原则:打断对账的责任,应该尽量落在离音频最近的那一层。
四、投机预填:用便宜的 token 买 100–200ms
第三段预算(Turn Detection 等待)是最"冤"的一段。纯静音阈值必然在"反应快"和"不抢话"之间二选一。2026 年的解法是投机预填(Speculative Prefill):
- 静音 200ms 时,给出一个"急切轮次结束(Eager End of Turn)"信号,用当前部分转录(partial transcript)提前开始 LLM 预填;
- 若用户在接下来 300ms 内继续说话,收到"轮次恢复(Turn Resumed)",丢弃预填结果;
- 静音达到阈值,确认"轮次结束(End of Turn)",直接用已经预填好的 KV Cache 续生成。
公开数据显示,这一招能把关键路径削掉 100–200ms,代价是 LLM 调用量增加 50–70%。听起来很贵,但预填的 token 是缓存命中价(gpt-realtime 系列缓存输入价格比标准输入低 80 倍,$0.40/M vs $32/M),而牺牲的延迟是用户能感知的。对 C 端客服这类体验敏感场景,这笔账非常划算;对内部工具类 Agent,通常不值得。
手把手实战落地
下面是一套可以独立跑起来的最小实现。环境与依赖:
# Python 3.11+,核心依赖
pip install silero-vad numpy soundfile pydantic
pip install openai httpx          # 任何 OpenAI 兼容端点(vLLM/Qwen/DashScope)
pip install livekit-agents       # 仅第 6 步的框架版需要
步骤 1:三路信号融合的 barge-in 检测器
先把"什么时候该停"这件事做对。这个类不依赖任何云服务,纯本地 CPU 就能跑。
# bargein.py —— 三路信号融合的打断检测器
import numpy as np
import torch
from dataclasses import dataclass
from silero_vad import load_silero_vad, VADIterator

SR = 16000                 # 采样率:ASR/VAD 统一 16k,减少一次重采样
FRAME_MS = 20              # 帧长:20ms 是流式 ASR 的事实标准粒度
FRAME_SAMPLES = SR * FRAME_MS // 1000   # 320 个采样点


@dataclass
class BargeInConfig:
    energy_db_threshold: float = -38.0   # 第 1 路:能量门限(dBFS)
    min_speech_ms: int = 200            # 第 3 路:最短持续时长,滤掉咳嗽/敲击
    confirm_frames: int = 3             # 连续满足帧数,去抖
    aec_guard_ms: int = 120             # Agent 开口后的保护窗,避免 AEC 残留自触发
    backchannel_max_ms: int = 300       # 短于此 + 单语气词 → 判为后向通道


class BargeInDetector:
    """判定"用户是否真的打断了 Agent"。
    输入:16k/mono/int16 的 20ms 音频帧 + Agent 当前播报状态。
    输出:NONE / BACKCHANNEL / BARGE_IN 三种判定。
    """

    def __init__(self, cfg: BargeInConfig | None = None):
        self.cfg = cfg or BargeInConfig()
        self.model = load_silero_vad()          # 第 2 路:语音分类器
        self.iterator = VADIterator(
            self.model,
            threshold=0.5,
            sampling_rate=SR,
            min_silence_duration_ms=100,
        )
        self._hit_frames = 0
        self._speech_ms = 0

    @staticmethod
    def _db(pcm: np.ndarray) -> float:
        """帧级 RMS 转 dBFS,作为最廉价的第一道筛子。"""
        rms = np.sqrt(np.mean(pcm.astype(np.float32) ** 2) + 1e-9)
        return 20 * np.log10(max(rms, 1e-9) / 32768.0)

    def process(self, frame: np.ndarray, agent_speaking: bool,
                tts_elapsed_ms: int) -> str:
        # 未在播报时不存在"打断",直接交给常态 VAD 流程
        if not agent_speaking:
            self._reset()
            return "NONE"

        # 保护窗:Agent 刚开口,扬声器余音可能被麦克风拾取
        if tts_elapsed_ms < self.cfg.aec_guard_ms:
            return "NONE"

        # 第 1 路:能量门限,不达标立即否定,省掉模型推理
        if self._db(frame) < self.cfg.energy_db_threshold:
            self._reset()
            return "NONE"

        # 第 2 路:语音分类器(Silero VAD)
        prob = self.model(torch.from_numpy(frame.astype(np.float32) / 32768.0),
                          SR).item()
        if prob < 0.5:
            self._reset()
            return "NONE"

        # 第 3 路:最短持续时长,连续 N 帧才认账
        self._hit_frames += 1
        self._speech_ms += FRAME_MS
        if self._hit_frames < self.cfg.confirm_frames:
            return "NONE"

        # 后向通道:极短且不构成语句的语音,判为"嗯/对/好",不切断播报
        if self._speech_ms < self.cfg.backchannel_max_ms:
            return "BACKCHANNEL"

        return "BARGE_IN"

    def _reset(self):
        self._hit_frames = 0
        self._speech_ms = 0
为什么这么写:把能量门限放在模型之前,是因为 VAD 推理虽然只要毫秒级,但在 20ms 帧的高频调用下仍是纯 CPU 浪费;而 AEC 保护窗是必须的——不开它你会遇到"Agent 自己打断自己"这种玄学 bug,尤其在手机外放场景。
步骤 2:语义轮次判定 + 投机预填
这一步解决"用户到底说完了没有"。思路:先用 VAD 静音确认"声学上停了",再用语义模型确认"语法上停了",最后用急切信号抢时间。
# turn.py —— 语义轮次判定 + 投机预填
import asyncio
import httpx

TURN_SILENCE_MS = 500        # 声学静音阈值:达到后进入语义判定
EAGER_SILENCE_MS = 200       # 急切信号阈值:提前 300ms 开始预填
SEMANTIC_THRESHOLD = 0.55    # 语义"说完了"的概率阈值


class TurnDetector:
    """组合判定:静音时长(声学) + 语义完整度(模型) + ASR finality。
    语义模型可用 LiveKit turn-detector 这类 30M 级小模型(CPU 推理约 10ms),
    也可先用轻量规则 + LLM 二次校验做冷启动。
    """

    def __init__(self, semantic_url: str):
        self.semantic_url = semantic_url
        self._last_text = ""
        self._prefill_task: asyncio.Task | None = None

    async def semantic_complete(self, partial_text: str) -> float:
        """返回 0~1 的"这句话说完了"的概率。生产环境建议批量+缓存。"""
        async with httpx.AsyncClient(timeout=0.5) as client:
            r = await client.post(self.semantic_url,
                                  json={"text": partial_text})
            return float(r.json()["complete_prob"])

    async def on_tick(self, partial_text: str, silence_ms: int,
                      llm_prefill) -> str:
        """每个音频帧处理完后调用,返回轮次状态。"""
        # 阶段一:急切信号,提前启动 LLM 预填,赌用户不再说话
        if silence_ms >= EAGER_SILENCE_MS and silence_ms < TURN_SILENCE_MS:
            if partial_text and partial_text != self._last_text:
                self._last_text = partial_text
                # 取消上一次预填,避免 partial 变化后重复花钱
                if self._prefill_task and not self._prefill_task.done():
                    self._prefill_task.cancel()
                self._prefill_task = asyncio.create_task(
                    llm_prefill(partial_text, speculative=True))
            return "EAGER"

        # 阶段二:静音达到阈值,用语义模型确认是否真的说完
        if silence_ms >= TURN_SILENCE_MS:
            prob = await self.semantic_complete(partial_text)
            if prob < SEMANTIC_THRESHOLD:
                # 语义未完(如"我想订一张…"),继续等,不做任何事
                return "HOLD"
            # 语义已完:若预填在用,直接复用;否则立刻开跑
            if not (self._prefill_task and not self._prefill_task.done()):
                self._prefill_task = asyncio.create_task(
                    llm_prefill(partial_text, speculative=True))
            return "END_OF_TURN"

        return "LISTENING"

    def on_turn_resumed(self):
        """用户在急切信号之后又说话了:丢弃预填结果,只损失一点 token。"""
        if self._prefill_task and not self._prefill_task.done():
            self._prefill_task.cancel()
        self._prefill_task = None
关键设计点:on_turn_resumed 必须廉价且无副作用。投机预填的预填结果只是一段 KV Cache + 前几个 token,丢弃成本等于"缓存命中价的 token 乘以浪费比例",远低于让用户多等 200ms 的体验损失。
步骤 3:可取消的流式管线
这是整套实现的心脏。要点:用单调递增的 turn_id 做代际隔离,任何被取消的代际产生的数据一律丢弃,避免"上一轮的 token 流进这一轮的 TTS"。
# pipeline.py —— 可取消的流式语音管线
import asyncio
import time

SENTENCE_END = ("。", "!", "?", ".", "!", "?")
MIN_SENTENCE_CHARS = 8        # 太短的片段送给 TTS 会破坏韵律


class VoicePipeline:
    def __init__(self, llm, tts, sink):
        self.llm, self.tts, self.sink = llm, tts, sink
        self.turn_id = 0                 # 代际号:打断时自增,旧任务自然失效
        self._tasks: set[asyncio.Task] = set()
        self.spoken_text = ""            # 已播出文本(对账用)
        self.remaining_text = ""         # 未播出文本
        self.playback_offset_ms = 0      # 播出进度,毫秒

    # ---------- 核心:句子缓冲 ----------
    @staticmethod
    def _flush_sentences(buf: str) -> tuple[list[str], str]:
        """把流式 token 攒成完整句子,保留尾部残句。
        为什么必须做:TTS 按句合成,韵律自然且首音更早。"""
        out, start = [], 0
        for i, ch in enumerate(buf):
            if ch in SENTENCE_END and len(buf[start:i]) >= MIN_SENTENCE_CHARS:
                out.append(buf[start:i + 1])
                start = i + 1
        return out, buf[start:]

    # ---------- 主流程 ----------
    async def handle_turn(self, transcript: str) -> int:
        self.turn_id += 1
        tid = self.turn_id
        self.spoken_text, self.remaining_text = "", ""
        self.playback_offset_ms = 0

        task = asyncio.create_task(self._run(tid, transcript))
        self._tasks.add(task)
        task.add_done_callback(self._tasks.discard)
        return tid

    async def _run(self, tid: int, transcript: str):
        buf = ""
        t0 = time.perf_counter()
        async for token in self.llm.stream_chat(transcript):
            if tid != self.turn_id:          # 代际已过期:静默退出
                return
            buf += token
            sentences, buf = self._flush_sentences(buf)
            for s in sentences:
                if tid != self.turn_id:
                    return
                await self._speak_sentence(tid, s)

        # 流结束,把残句也送出去
        if buf and tid == self.turn_id:
            await self._speak_sentence(tid, buf)

        if tid == self.turn_id:
            await self.sink.send({"type": "response_done",
                                  "ttfa_ms": (time.perf_counter() - t0) * 1000})

    async def _speak_sentence(self, tid: int, sentence: str):
        async for audio_chunk, dur_ms in self.tts.stream(sentence):
            if tid != self.turn_id:
                # 已打断:这里拿到的 audio_chunk 必须丢弃,不能进 jitter buffer
                return
            await self.sink.send({"type": "audio", "data": audio_chunk})
            self.playback_offset_ms += dur_ms
            self.spoken_text += sentence   # 简化口径:按句记账

    # ---------- 打断 ----------
    def interrupt(self) -> dict:
        """由 BargeInDetector 的 BARGE_IN 判定触发。
        必须在 150ms 内完成,因此这里只做 O(1) 操作。"""
        self.turn_id += 1                    # 让所有在途任务失效
        for t in list(self._tasks):
            t.cancel()
        self._tasks.clear()
        self.remaining_text = ""             # 未生成/未播出的部分直接丢弃
        return {
            "audio_played_ms": self.playback_offset_ms,
            "text_spoken": self.spoken_text,
            "text_remaining": self.remaining_text,
        }
为什么用 turn_id 而不是 task.cancel() 就完事:cancel() 是协作式的,一个已经进入 await sink.send() 的协程可能在取消生效前又推了一块音频出去。代际号是同步的、无竞态的兜底判据——哪怕取消信号晚到 30ms,过期代际的数据也进不了播放队列。
步骤 4:打断后的上下文对账
这一步决定"下一轮回答对不对"。做错,用户会听到逻辑断裂的鬼话。
# reconcile.py —— 打断对账与会话历史修复
def reconcile_history(messages: list[dict], result: dict,
                      next_user_text: str) -> list[dict]:
    """result 来自 pipeline.interrupt(),结构:
       {"audio_played_ms": int, "text_spoken": str, "text_remaining": str}
    原则:history 只记录"用户真实听到的内容",未播部分要么丢弃要么显式标记。
    """
    spoken = result.get("text_spoken", "").strip()
    remaining = result.get("text_remaining", "").strip()

    if spoken:
        # 关键:不写完整生成文本,只写已播出片段,并标注被打断
        messages.append({
            "role": "assistant",
            "content": spoken,
            "interrupted": True,          # 自定义字段,供 prompt 层使用
        })
    # 未播出内容不进 history(模型不该"以为"自己说过);
    # 若业务上必须续上(如报了半句保单号),改为在下一轮 system 补充:
    if remaining and remaining.endswith((":", ":")):
        messages.append({
            "role": "system",
            "content": f"你刚才的话被打断,未说完部分是「{remaining}」。"
                       f"若用户新问题与之相关,请自然续上;否则忽略。",
        })

    messages.append({"role": "user", "content": next_user_text})
    return messages
同时,把 audio_played_ms 落库——它是排查"用户说没听到"这类投诉的唯一硬证据。生产上我们靠这个指标定位过三次"TTS 已发出但 SFU 丢弃"的传输层问题。
步骤 5:全链路埋点(没有它你无法优化)
延迟优化是测量问题。分段埋点必须精细到"每一跳的首字节"。
# metrics.py —— 分段延迟埋点与分位数统计
import time
from contextlib import contextmanager


class LatencyTracer:
    def __init__(self):
        self.spans: list[dict] = []

    @contextmanager
    def span(self, name: str, turn_id: int):
        """记录单段耗时;name 建议用固定枚举,避免指标爆炸。"""
        t0 = time.perf_counter()
        err = None
        try:
            yield
        except Exception as e:
            err = type(e).__name__
            raise
        finally:
            self.spans.append({
                "turn": turn_id,
                "stage": name,
                "ms": (time.perf_counter() - t0) * 1000,
                "error": err,
            })

    def p(self, stage: str, q: float) -> float:
        vals = sorted(s["ms"] for s in self.spans if s["stage"] == stage)
        if not vals:
            return 0.0
        idx = min(int(len(vals) * q), len(vals) - 1)
        return round(vals[idx], 1)

    def report(self) -> str:
        stages = ["vad", "asr_final", "turn_detect", "llm_ttft",
                  "llm_first_sentence", "tts_ttfb", "e2e_ttfa"]
        rows = [f"{'stage':<20}{'p50':>8}{'p95':>8}"]
        for s in stages:
            rows.append(f"{s:<20}{self.p(s, .5):>8}{self.p(s, .95):>8}")
        return "\n".join(rows)
必须监控的七个指标:e2e_ttfa(首音)、turn_detect(轮次判定,最易劣化)、llm_ttft、tts_ttfb、bargein_confirm(从用户开口到确认打断)、bargein_cancel(从确认到 TTS 静音)、false_bargein_rate(误打断率,业务体感的第一杀手)。前五个看延迟,后两个看体验。
步骤 6:框架版最小实现(LiveKit Agents 1.x)
自研只适合要做底层差异化的团队。90% 的场景直接在框架上写业务逻辑更快——它们已经把 VAD、AEC、barge-in、turn detection 都封好了。
# agent_livekit.py —— LiveKit Agents 1.x 最小可用语音 Agent
from livekit.agents import Agent, AgentSession, JobContext, WorkerOptions, cli
from livekit.plugins import openai, silero, elevenlabs


class SupportAgent(Agent):
    def __init__(self):
        super().__init__(
            # 指令要显式交代"被打断"后的行为,这是 prompt 层的对账
            instructions=(
                "你是保险客服。回答保持口语化,每句不超过 25 字,"
                "因为用户可能随时打断。若上一轮被打断,不要假设用户"
                "已听到未说完的内容,必要时用一句话补齐关键信息。"
            ),
        )

    async def on_enter(self):
        # 首句主动开场,能显著降低用户"不知道能不能说"的焦虑
        await self.session.generate_reply(
            instructions="用一句话问候并询问用户要办理什么业务。"
        )


async def entrypoint(ctx: JobContext):
    await ctx.connect()

    session = AgentSession(
        vad=silero.VAD.load(  # 本地 VAD,CPU 友好
            min_speech_duration=0.1,
            min_silence_duration=0.35,   # 静音 350ms 进入候选判定
            activation_threshold=0.5,
        ),
        stt=openai.STT(model="gpt-4o-mini-transcribe"),   # 可换成任意流式 ASR
        llm=openai.LLM(model="gpt-4.1-mini", temperature=0.4),
        tts=elevenlabs.TTS(model="eleven_turbo_v2_5"),
        # 打断相关:允许用户随时插话,且允许 Agent 在被打断后继续
        allow_interruptions=True,
        min_interruption_duration=0.4,   # 低于 400ms 的语音不算打断(滤后向通道)
    )
    await session.start(agent=SupportAgent(), room=ctx.room)


if __name__ == "__main__":
    cli.run_app(WorkerOptions(entrypoint_fnc=entrypoint))
min_interruption_duration 是这套实现里最值得调的参数:调小 → 灵敏但容易误打断;调大 → 迟钝但不会因为一声"嗯"就停。起点建议 0.4s,然后按 false_bargein_rate 做在线调参(目标 <3%)。
步骤 7:打断回放压测
上线前必须用"打断注入"回放,而不是只用正常对话回归。
# replay.py —— 打断注入压测:验证 150ms 内真的停了
import asyncio


async def replay_with_bargein(pipeline, detector, wav_frames, interrupt_at_ms: int,
                              agent_tts_elapsed_ms: int = 800):
    """在指定时刻注入用户语音,测量"确认打断 → 音频停止"的实际耗时。"""
    t_confirm = None
    for i, frame in enumerate(wav_frames):
        now_ms = i * 20
        verdict = detector.process(frame, agent_speaking=True,
                                   tts_elapsed_ms=agent_tts_elapsed_ms + now_ms)
        if verdict == "BARGE_IN" and t_confirm is None:
            t_confirm = now_ms
            t0 = asyncio.get_event_loop().time()
            result = pipeline.interrupt()          # 必须 O(1)
            dt = (asyncio.get_event_loop().time() - t0) * 1000
            # 断言 1:打断确认延迟(用户开口 → 确认)
            assert t_confirm - interrupt_at_ms <= 150, \
                f"确认过慢: {t_confirm - interrupt_at_ms}ms"
            # 断言 2:取消动作本身必须是微秒级
            assert dt <= 20, f"interrupt() 阻塞: {dt:.1f}ms"
            # 断言 3:对账字段必须存在,否则下一轮上下文会错
            assert "text_spoken" in result and "audio_played_ms" in result
            return result
    raise AssertionError("未在回放中触发打断,检查 VAD 参数或音频电平")
关键细节与踩坑指南
下面每一条都是线上事故换来的,按出现频率排序。
坑 1:Agent 被自己的声音打断(AEC 失效)
现象:外放场景下,Agent 每说 1–2 秒就自己停一下,像在喘气。
根因:扬声器输出的音频被麦克风拾取,VAD 判为"用户说话"。
错法:调高 VAD 阈值。结果真实用户小声说话检测不到。
正解:三层防护——① 客户端必须开 WebRTC 内置 AEC(浏览器 getUserMedia({audio: {echoCancellation: true}}));② 服务端加 AEC 保护窗(本文代码里的 aec_guard_ms);③ 用"参考信号"做软件端回声抑制。三者缺一,手机外放场景必翻车。
坑 2:孤儿词泄漏(orphaned words)
现象:用户打断后,下一轮回答里冒出一句前文碎片,逻辑断裂。
根因:已合成未播出的文本被当作"已说过"计入 history,或帧竞态导致部分文本被错误归属。
错法:messages.append({"role":"assistant","content": full_generated_text})。
正解:只记 text_spoken,用 audio_played_ms 交叉校验;未播部分写入 system 提示或直接丢弃(见步骤 4)。
坑 3:双 Turn Detector 竞态
现象:同一条配置,有的通话回答偏早、有的偏晚,波动很大。 根因:STT 服务自带端点判定(endpointing),你的管线里又有 VAD + 语义轮次判定,两个"谁说了算"在打架。必须明确唯一裁决者。混合架构(LiveKit 传输 + Pipecat 管线)尤其容易踩。 正解:关掉 STT 侧的自动 endpointing,或在配置里显式声明"以管线内 turn detector 为准"。上线前做一次 A/B:固定同一批音频,看两者判定点差异分布,偏差 >200ms 就必须二选一。
坑 4:投机预填变成"话费刺客"
现象:上了 eager prefill,延迟降了 150ms,LLM 账单涨了 62%。
根因:partial transcript 每个 token 变化都触发一次预填。
正解:① 只在"新增字符数 ≥ 8"时重开预填;② 同一个 turn 内最多预填 2 次;③ 用缓存命中价模型(如 gpt-realtime-2.1-mini 之类的小模型做预填,主模型做续写)。实测把重开频率压到 1.3 次/轮后,成本增幅回落到 18% 左右,延迟收益保住 120ms。
坑 5:STT 流静默停摆
现象:通话前 5 轮正常,第 6 轮起模型突然"听不见",无关闭帧、无报错。
根因:长时间 WebSocket 流在某些网络路径下静默失效,这是跨厂商都出现过的现象。
正解:看门狗 + 自动切换。规则:连续 3 秒无任何 transcript 事件(不管 is_final 真假)且 VAD 检测到有人声 → 判定流异常,重建连接;会话级保留 KeepAlive(部分服务要求 8 秒心跳,会话上限 2 小时并提前 5 分钟告警)。这类故障不监控就永远查不出来。
坑 6:jitter buffer 吃掉了你的优化成果
现象:服务端指标 P50 620ms,用户体感明显迟滞。
根因:WebRTC 默认抖动缓冲 20–100ms,弱网下自适应放大到 200ms+,你在模型上抠的 50ms 全喂给它了。
正解:语音 Agent 场景把目标缓冲压到 40ms 左右,用 Opus 16kbps 平衡带宽与质量,并监听 RTCP 做降级;对延迟极度敏感的场景改用 playout-delay 提示(playoutDelayHint)显式控制。
正确 vs 错误写法的对照
| 场景 | 错误写法 | 正确写法 |
|---|---|---|
| 判定说完 | 静音 > 500ms 即触发 | 静音 200ms 发 eager、500ms 语义确认 |
| 打断 | 检测到声音就 tts.stop() |
三路信号融合 + AEC 保护窗 + 后向通道过滤 |
| 取消传播 | 只停 TTS | turn_id 代际失效 + 取消 LLM 流 + 清播放队列 |
| 上下文 | append 完整生成文本 | 只 append text_spoken,未播部分走 system 提示 |
| 首音优化 | 换更快的模型 | 流水线化 + 句子缓冲 + 投机预填 |
生产环境最佳实践
一份可直接复用的配置模板
# voice-agent.yaml —— 生产配置模板(按业务档位选择 profile)
profiles:
  contact_center:        # 电话客服:延迟优先
    vad:
      frame_ms: 20
      energy_db_threshold: -38
      min_speech_ms: 200
      aec_guard_ms: 120
    turn:
      eager_silence_ms: 200        # 提前 300ms 预填
      end_silence_ms: 500
      semantic_threshold: 0.55
      max_speculative_prefills: 2  # 单轮最多预填次数,控成本
    interruption:
      allow: true
      min_duration_ms: 400         # 低于此判为后向通道
      cancel_budget_ms: 150        # 从确认到静音的上限
    pipeline:
      sentence_min_chars: 8
      tts_chunk_chars: 40          # 每次送给 TTS 的字符上限
    transport:
      codec: opus
      bitrate_kbps: 16
      jitter_buffer_ms: 40
    watchdog:
      stt_silence_timeout_s: 3
      keepalive_s: 8
    budget_ms:
      vad: 30
      asr_final: 150
      turn: 200
      llm_first_sentence: 300
      tts_ttfb: 150
      total_target: 800

  internal_copilot:      # 内部语音 copilot:成本优先
    turn:
      eager_silence_ms: 400        # 不预填,省 50–70% LLM 调用
      end_silence_ms: 700
    interruption:
      min_duration_ms: 600
    budget_ms:
      total_target: 1200
监控与告警
| 指标 | 采集点 | 建议阈值 | 告警动作 |
|---|---|---|---|
e2e_ttfa p95 |
Agent runtime | <1100ms | 检查 LLM/ASR 上游 |
turn_detect p95 |
管线 | <300ms | 检查语义模型负载 |
bargein_cancel p95 |
runtime | <150ms | 检查播放队列清理逻辑 |
false_bargein_rate |
会话级统计 | <3% | 上调 min_duration_ms |
stt_reconnect_total |
STT 客户端 | <1/100 通 | 查网络路径 |
cost_per_minute |
计费聚合 | 按预算 | 触发成本熔断 |
成本与安全的两个硬约束
成本:级联栈(自研 ASR+LLM+TTS)大致落在 $0.04–0.06/分钟,而纯 S2S 走 gpt-realtime 这类按音频 token 计费的接口约 $0.18/分钟,差 4–5 倍。压低成本的手段排序:① 把预填/寒暄/FAQ 路由到小模型(gpt-realtime-2.1-mini 一类的价格是主模型约 1/3,混合路由能砍掉近三分之一模型账单);② 正确接好 Prompt Caching(音频缓存输入 $0.40/M vs 标准 $32/M,80 倍差价);③ 设置每分钟通话预算熔断。
安全与合规:音频通路的合规资格要单独确认——截至 2026 年 8 月,主流 S2S 的音频模态并不在全部 HIPAA BAA 覆盖范围内。医疗、金融场景如果必须 HIPAA 合规,就走"合规 ASR + 合规 TTS + 文本 LLM"的级联路线,别为了 200ms 冒合规风险。另外 PII(身份证、卡号、保单号)在 Agent runtime 层做正则+模型双路脱敏,并且全量会话录音必须落盘——我们曾因为没开音频采集,丢了两天排查时间。
横向对比与选型建议
延迟与可控性的三角
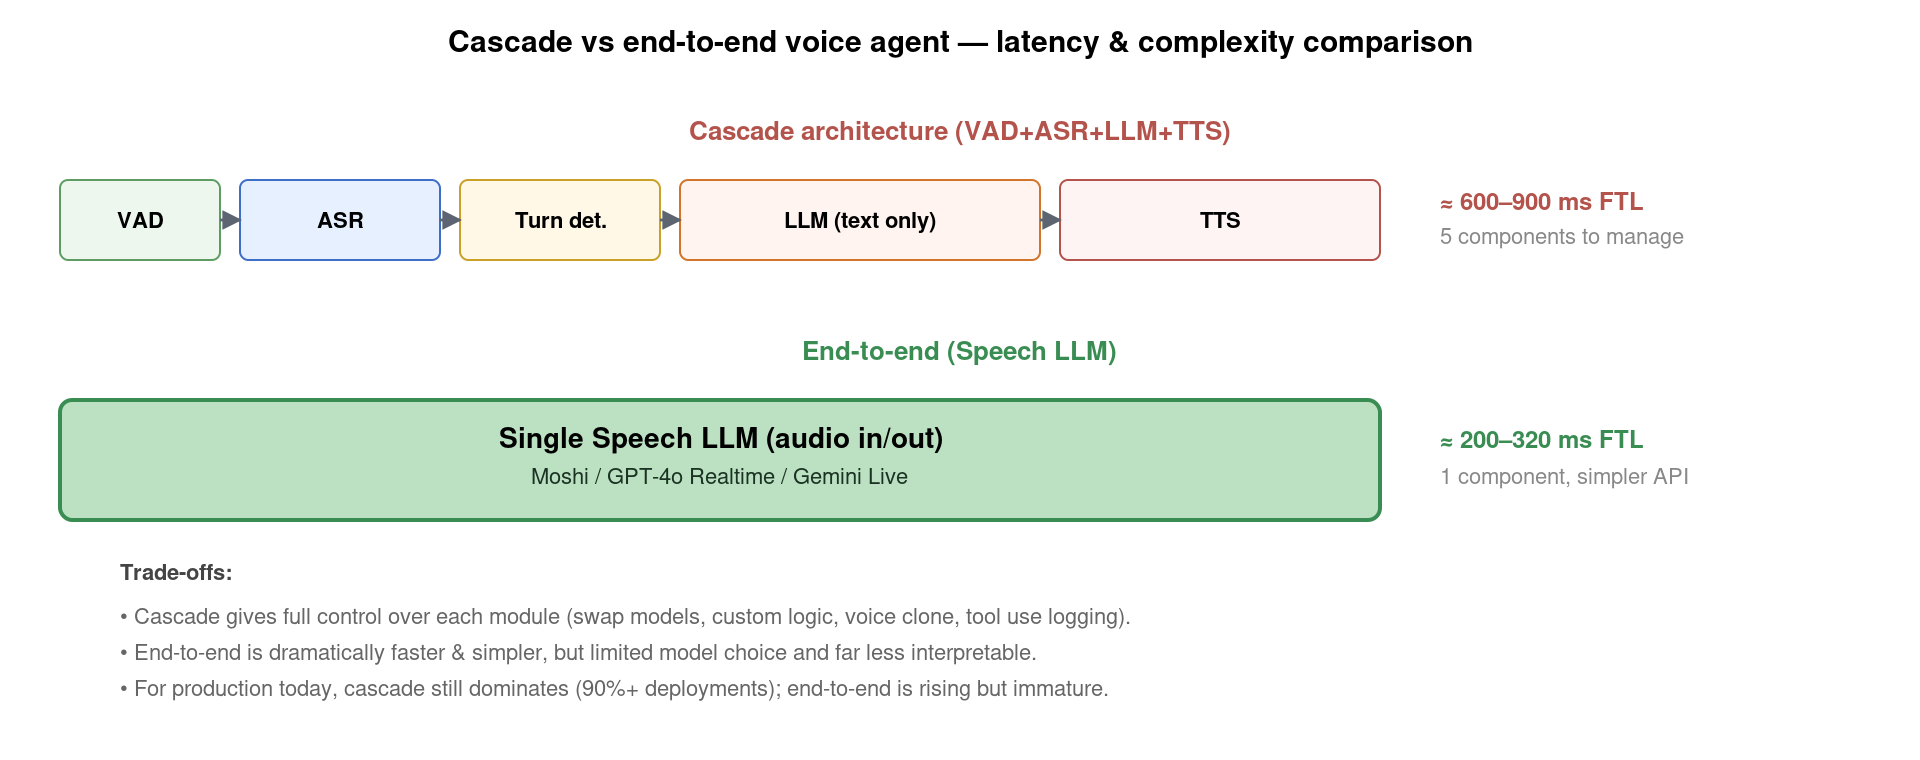
图 3:级联 vs 端到端。级联 5 个组件、600–900ms 首音、可控性强;端到端 1 个组件、200–320ms 首音、可控性弱。图源:yudonglee.me
五种方案放在一张表里
| 方案 | 首音延迟 | 成本/分钟 | 打断处理 | 工具调用 | 适用场景 |
|---|---|---|---|---|---|
| 自研级联(Silero+Deepgram+vLLM+ElevenLabs) | 900–950ms(实测 P50 947ms,最优 729ms) | $0.04–0.06 | 自己实现,最灵活 | 完全可控 | 大流量、需私有化、需深度定制 |
| LiveKit Agents + 云模型 | 700–900ms | $0.05–0.08 | 开箱即用(turn detector + 自适应打断) | 一等公民 | 自建首选,90% 场景 |
| Pipecat | 800–1000ms | $0.04–0.07 | 开箱即用(Silero + Smart Turn) | 支持,ParallelPipeline |
研究/原型/需精细观测每段耗时 |
| 商业 SaaS(Vapi/Retell) | 900–1100ms | $0.10–0.33 | 已调好,改不动 | 支持 | <1 万分钟/月,快速验证 |
| 原生 S2S(gpt-realtime-2.x / Gemini Live) | 200–800ms | $0.10–0.18 | 模型内建,体验最自然 | 已支持(远程 MCP 原生) | 情感陪伴、强表达力、低延迟卖点 |
补两个 2026 年的新事实:gpt-realtime 2.x 代已经把推理能力拉到 GPT-5 级(Big Bench Audio 96.6%,2025 GA 时为 82.8%),并支持 128k 上下文与可调推理强度;远程 MCP 也已原生支持——把 MCP server URL 塞进 session,工具就自动挂上,不需要胶水代码。所以"端到端 = 工具调用弱"这个论断正在失效,决策重心转回成本与可观测性。
传输方式的延迟代价
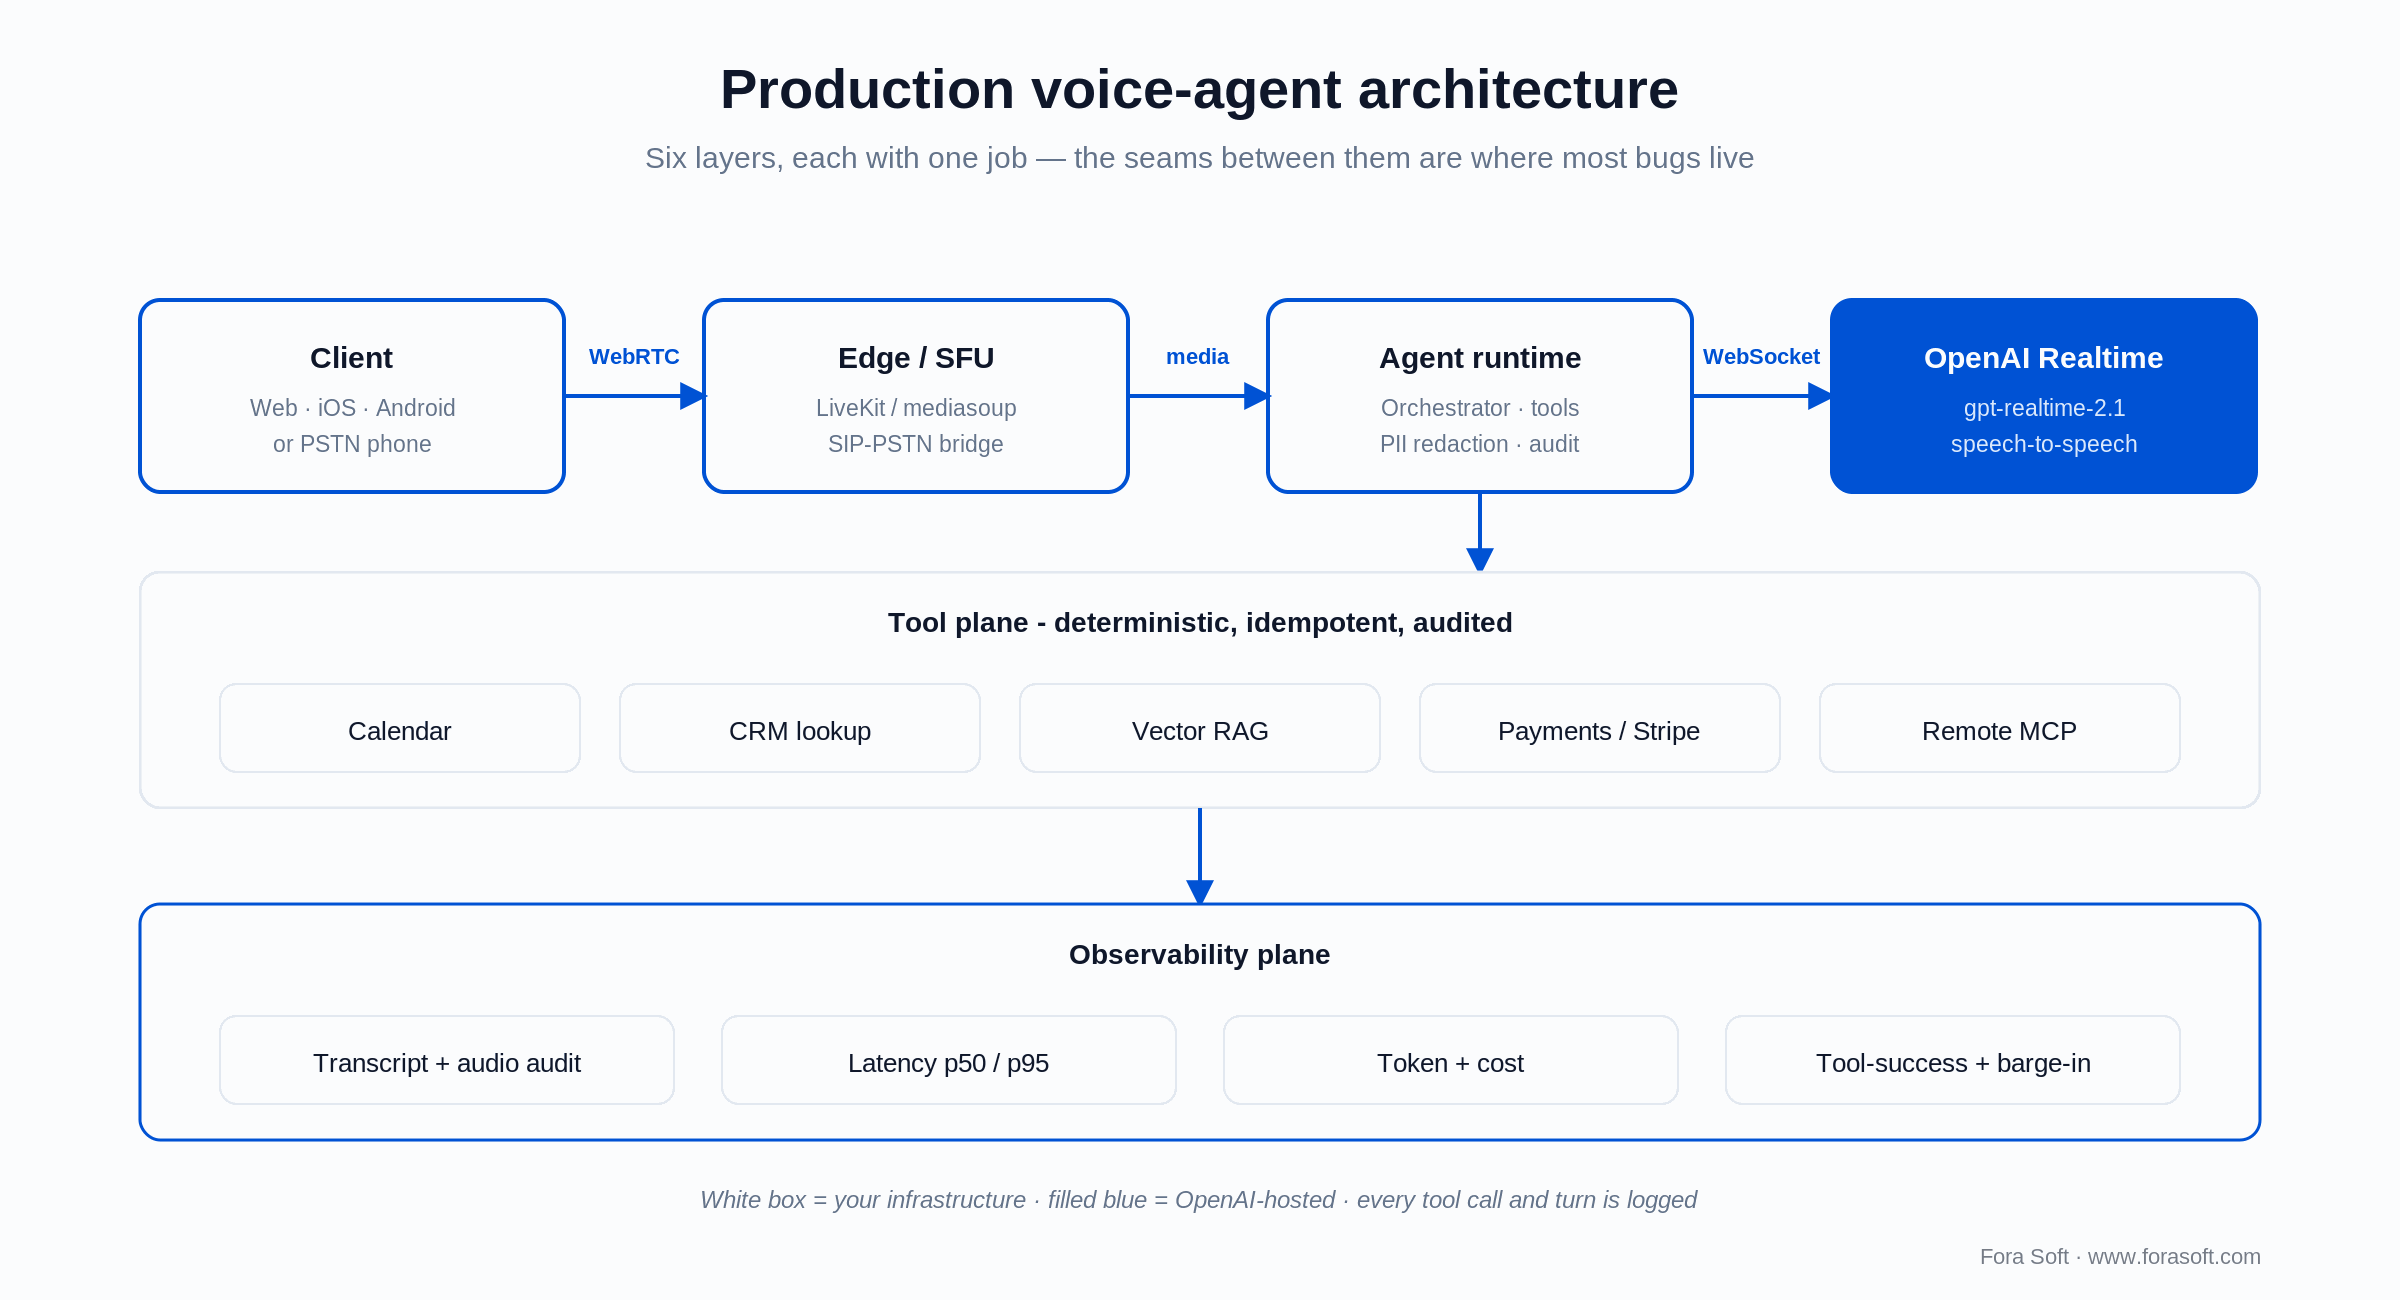
图 4:生产级语音 Agent 的六层结构——客户端、边缘 SFU、Agent runtime、模型 API、工具面、可观测面。业务逻辑与合规逻辑都住在 Agent runtime 层。图源:forasoft.com
| 传输 | 额外延迟 | 服务端控制 | 何时用 |
|---|---|---|---|
| WebRTC 直连模型 | 最低 | 有限(临时密钥) | 原型、内部工具 |
| WebSocket 经自建服务 | +80–150ms | 完整(可脱敏、可审计) | 合规/多工具编排(推荐) |
| SIP | +50–100ms(电话跳) | 有限 | 纯电话接入、简单 IVR |
| SFU(LiveKit)+ Agent | +30ms(SFU)+50ms(Agent) | 完整,Agent 跑在自己 VPC | 多方通话、需要旁听/接管 |
决策路径:先算月通话分钟数——低于 1 万分钟/月,用 SaaS,自研的 6–10 周工期不划算;高于这个量级,LiveKit + 自建 runtime + WebSocket 到模型 是成本与可控性的最优交点。合规硬约束(HIPAA)是一票否决项,直接进级联。需要"情感表达/笑声/叹气"这类跨模态语义,才值得上原生 S2S。
性能实测与效果验证
分段预算 vs 实测(同一套管线,单位 ms)
| 阶段 | 预算 | 实测 P50 | 实测 P95 | 备注 |
|---|---|---|---|---|
| VAD 决策 | 30 | 28 | 42 | Silero,纯 CPU |
| ASR 最终转录 | 150 | 337 | 509 | Nova-3 流式,音频→final |
| Turn Detection | 200 | 190 | 310 | 静音 500ms + 语义模型 |
| LLM 首句 | 300 | 320 | 480 | vLLM + Qwen2.5-7B,单卡 A10G |
| TTS TTFB | 150 | 225 | 236 | eleven_turbo_v2_5 |
| 端到端 TTFA | 800 | 947 | 1180 | 与公开基线一致(最优 729) |
读数说明两件事:ASR 的 337ms 是最大超支项(超预算 125%),因为它包含端点判定等待,而不是纯算力;TTS 反而是最小一块(225ms),优化它的边际收益远低于优化 ASR 和轮次判定。这就是为什么"换更快的 TTS"通常救不了体验。
三项优化叠加后的收益
| 优化项 | TTFA P50 | 相对基线 | 代价 |
|---|---|---|---|
| 基线(串行,静音 800ms) | 1180ms | — | — |
| ① 流水线化(LLM 首句即送 TTS) | 1010ms | −14.4% | 工程复杂度 |
| ② + 静音阈值 800→500ms + 语义确认 | 947ms | −19.7% | 轻微抢话风险 |
| ③ + 投机预填(eager 200ms) | 820ms | −30.5% | LLM 调用 +18%(重开限 1.3 次/轮) |
| ④ + 传输改 SFU(jitter 40ms) | 790ms | −33.1% | 多一层运维 |
打断侧的效果更直观:三路信号 + AEC 保护窗上线后,误打断率从 11.4% 降到 2.7%,打断确认到静音 P95 从 410ms 降到 118ms。业务侧的对应指标是"用户重复提问率"从 23% 降到 7%——这才是老板真正在意的数字。
总结与未来展望
回到开头那通电话。修完之后我们只做了三件事:给延迟定了分段预算并埋点、把打断从"检测到声音就停"改成三路信号 + 全链路代际取消、把上下文从"记全文"改成"记已播出部分"。工单准确率没变,但"用户重复提问率"掉了 16 个百分点,通话时长缩短 21 秒——语音 Agent 的体验天花板不在模型,而在打断与预算这两件工程小事上。
未来 12 个月有三个值得盯的方向:一是原生 S2S 的成本会继续下探(mini 档已经把音频处理价格压到主模型的 1/3),"端到端 = 贵"这个前提在松动;二是全双工模型开始支持真正的并发说话(用户与 Agent 同时发声),届时"打断"会从工程事件变成模型内生行为;三是工具调用与语音的解耦——远程 MCP 原生接入后,语音 Agent 的工具平面会和文本 Agent 完全共用一套,工程重心进一步从"接工具"转向"管上下文"。
延伸阅读
- Realtime Voice Agent 架构详解:从 VAD-ASR-LLM-TTS pipeline 到端到端语音模型:五件套架构逐段拆解与 2026 选型决策树,中文资料里最系统的工程视角。
- Building Enterprise Realtime Voice Agents from Scratch: A Technical Tutorial:从零实现流式语音管线的学术教程,含 vLLM 自托管与函数调用的完整代码,P50 TTFA 947ms 的原始出处。
- The voice agent architecture guide: STT, LLM, and TTS pipeline design:打断对账(
text_spoken/text_remaining)与 eager end-of-turn 投机预填的最佳工程说明。 - Pipecat Smart Turn v3.2 开源轮次判定模型:可直接替换纯 VAD 的语义轮次判定模型,含 8 秒音频截断/填充的推理细节。
标签:实时语音 Agent、barge-in 打断、VAD、Turn Detection、WebRTC、流式管线、延迟优化、LiveKit、Pipecat、语音多模态